Modelos basados en árboles
Ruta de la clase
- Construir y podar árboles.
- Usarlos para regresión y clasificación.
- Reducir varianza con Random Forest.
- Reducir sesgo con Gradient Boosting.
- Comparar desempeño e interpretación.
Referencia principal: James et al. (2021), An Introduction to Statistical Learning, 2ª ed., capítulo 8 (sitio oficial).
La solicitud predictiva no cambia
Al cierre de cada día, estimar qué horas del día siguiente tendrán demanda alta, para priorizar el rebalanceo de bicicletas.
Mantenemos unidad, horizonte, predictores disponibles, partición temporal y costo 3:1 de las clases 15–16. Así, cualquier diferencia en desempeño proviene del modelo y no de haber cambiado la pregunta.
Hoy preguntamos si reglas aprendidas de los datos pueden capturar picos, umbrales e interacciones sin escribir I(temp^2) o factor(hr) * workingday a mano.
Retomando la pregunta de la clase pasada
La clase 16 terminó con una pregunta sin responder: regularización controla cuánta complejidad usar, pero seguimos siendo nosotros quienes escribimos a mano qué interacciones probar (I(temp^2), factor(hr)*workingday…). Cuando agregamos la interacción completa hora×mes, no sabíamos de antemano cuáles de esas variables eran señal y cuáles ruido.
Hoy cambiamos de estrategia por completo: ¿puede el propio modelo aprender qué preguntas de sí/no —y en qué orden— separan mejor las horas de demanda alta?
En vez de una ecuación con términos que nosotros elegimos, construiremos reglas: “¿es hora punta? → ¿hace calor? → ¿es día hábil?”. Las interacciones emergen de los datos, no de nuestras hipótesis.
Configuración: outcome y partición
Mantenemos el mismo outcome y la misma partición cronológica del módulo:
Configuración: predictores y fórmulas
A diferencia de la regresión regularizada, los árboles usan las variables directamente, sin expandirlas en una matriz de diseño:
Sin I(temp^2) ni interacciones escritas a mano: el árbol las descubrirá solo.
Diseño de evaluación
# A tibble: 3 × 4
  conjunto       días horas período
  <chr>         <int> <int> <chr>
1 Entrenamiento   219  5162 1–219
2 Validación       73  1735 220–292
3 Test             73  1748 293–365
La partición cronológica exige predecir períodos futuros. Además, el umbral de demanda alta se aprende sólo con entrenamiento.
Un árbol, en una frase
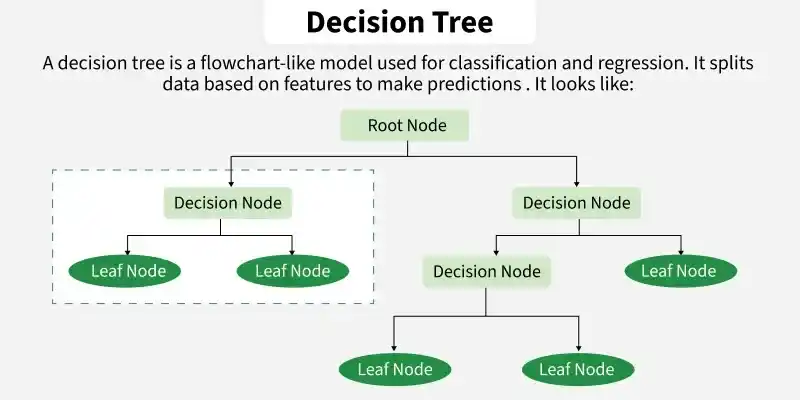
Un árbol de decisión funciona como un diagrama de flujo: una secuencia de preguntas de sí/no que termina en una respuesta.
![]()
Diagrama de un árbol de decisión: nodo raíz, nodos internos, ramas y hojas.
Vocabulario del árbol
| Nodo raíz |
la primera pregunta; contiene todos los datos de entrenamiento |
| Nodo interno |
una pregunta intermedia sobre un predictor (p. ej. ¿temp < 20°C?) |
| Rama |
el camino que se sigue según la respuesta (sí/no) |
| Hoja |
el nodo final: ahí vive la predicción |
Cada palabra técnica que sigue en esta clase (partición, poda, impureza) describe cómo se eligen estas preguntas y dónde se detiene el árbol.
La idea
Un árbol divide recursivamente el espacio de predictores en regiones simples.
- Cada nodo formula una pregunta binaria.
- Cada rama representa una respuesta.
- Cada hoja contiene una predicción.
- Las interacciones aparecen sin escribirlas manualmente.
El modelo de un árbol
Un árbol parte el espacio de predictores en regiones R_1,\dots,R_M y predice una constante en cada una:
\hat f(x)=\sum_{m=1}^{M}c_m\,\mathbb{1}(x\in R_m).
| R_1,\dots,R_M |
las M regiones (hojas) en que queda partido el espacio de predictores |
| \mathbb{1}(x\in R_m) |
1 si la observación x cae en la región m; 0 en caso contrario |
| c_m |
la predicción constante asignada a la región R_m |
- Las regiones son rectángulos: cada corte es perpendicular a un eje (una pregunta sobre una variable a la vez).
- Regresión: c_m= media de y en R_m. Clasificación: proporción/clase mayoritaria en R_m.
- Hallar la partición óptima (qué R_m minimizan el error total) es NP-difícil, así que se construye de forma greedy: se elige la mejor pregunta ahora, sin planear varios pasos adelante.
Una partición
Una división candidata tiene la forma X_j < s. Para regresión buscamos j y s que reduzcan:
\sum_{i:x_{ij}<s}(y_i-\bar y_L)^2+
\sum_{i:x_{ij}\ge s}(y_i-\bar y_R)^2.
El algoritmo es greedy: elige la mejor división actual, sin garantizar el árbol globalmente óptimo.
Regresión versus clasificación
| Regresión |
media de bikers |
suma de errores cuadrados |
| Clasificación |
proporción de demanda alta |
Gini o entropía |
Para dos clases, la impureza de Gini es:
G=1-\left[p^2+(1-p)^2\right].
Tres medidas de impureza
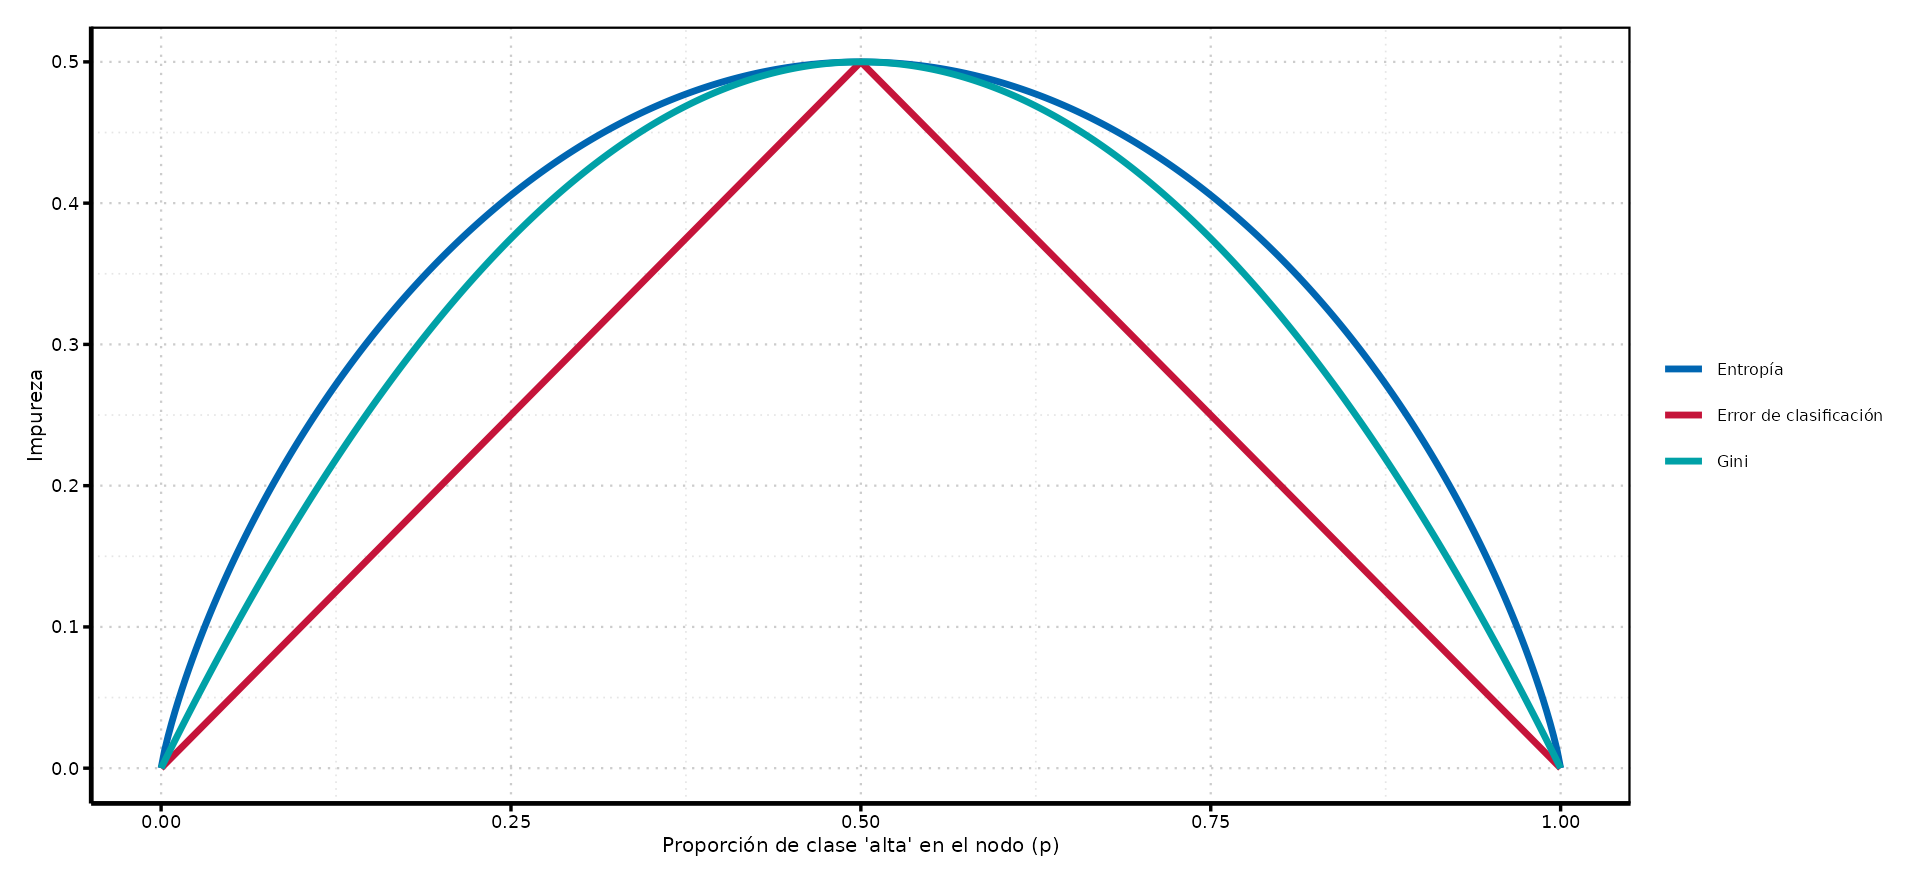
Intuición: si un nodo tiene 3 horas de demanda “alta” y 3 de “baja”, no sabemos casi nada sobre qué esperar ahí — impureza alta. Si tiene 6 “altas” y 0 “bajas”, el nodo es homogéneo — impureza cero. Las tres medidas de abajo formalizan esa misma idea.
Para dos clases con proporción p de “alta” en un nodo:
E=1-\max(p,1-p),\quad
G=2p(1-p),\quad
D=-p\log p-(1-p)\log(1-p).
![]()
Por qué Gini o entropía, no el error
- Las tres se minimizan en nodos puros (p=0 o p=1) y se maximizan en p=0.5.
- El error de clasificación es plano por tramos: no distingue un nodo con p=0.3 de uno con p=0.1.
- Gini y entropía son suaves y cóncavas: premian empujar p hacia los extremos, así que guían mejor la búsqueda de cortes.
- Gini =2p(1-p) es también la varianza de un Bernoulli: mide la “mezcla” del nodo.
Para podar sí se puede usar el error de clasificación; para crecer, Gini o entropía funcionan mejor.
Árbol de regresión: ejemplo empírico
n= 5162

node), split, n, deviance, yval
      * denotes terminal node

  1) root 5162 87560000 134.900
    2) hour< 6.500 1459  1290000  23.840
      4) hour< 5.500 1243   729300  18.960
        8) hour>=1.500 811   148500  11.370 *
        9) hour< 1.500 432   446300  33.220
         18) workingday>=0.500 294   105900  20.710 *
         19) workingday< 0.500 138   196400  59.860
           38) month< 4.500 76    22110  31.390 *
           39) month>=4.500 62    37220  94.760 *
      5) hour>=5.500 216   361800  51.880
       10) workingday< 0.500 68     8980  13.720 *
       11) workingday>=0.500 148   208200  69.420
         22) month< 4.500 80    23640  39.490 *
         23) month>=4.500 68    28600 104.600 *
    3) hour>=6.500 3703 61200000 178.600
      6) temp< 0.470 1703  8002000  98.300
       12) hour>=19.500 428   532700  57.140
         24) temp< 0.410 366   261100  50.150 *
         25) temp>=0.410 62   148200  98.390 *
       13) hour< 19.500 1275  6500000 112.100
         26) temp< 0.310 678  1988000  91.670
           52) workingday< 0.500 196   303500  64.980
            104) hour< 9.500 67    34370  28.240 *
            105) hour>=9.500 129   131700  84.070 *
           53) workingday>=0.500 482  1488000 102.500
            106) hour>=9.500 336   703400  86.430
              212) hour< 16.500 233    73700  62.210 *
              213) hour>=16.500 103   183900 141.200 *
            107) hour< 9.500 146   496700 139.600
              214) hour< 7.500 51    32700  90.220 *
              215) hour>=7.500 95   273000 166.100
                430) hour>=8.500 46    24450 126.100 *
                431) hour< 8.500 49   106300 203.600 *
         27) temp>=0.310 597  3907000 135.300
           54) weather=light rain/snow 82   304300  71.910 *
           55) weather=clear,cloudy/misty 515  3221000 145.400
            110) hour< 16.500 391  2342000 133.100
              220) temp< 0.410 277  1159000 118.600 *
              221) temp>=0.410 114   983900 168.300
                442) month< 3.500 61   299500 140.300 *
                443) month>=3.500 53   582000 200.400 *
            111) hour>=16.500 124   632200 184.300
              222) workingday< 0.500 51   177300 140.600 *
              223) workingday>=0.500 73   289600 214.800 *
      7) temp>=0.470 2000 32860000 247.000
       14) hour>=20.500 329  1151000 148.000
         28) hour>=22.500 105   135500  99.370 *
         29) hour< 22.500 224   651100 170.800
           58) hour>=21.500 112   193300 147.500 *
           59) hour< 21.500 112   336700 194.000 *
       15) hour< 20.500 1671 27840000 266.500
         30) hour< 16.500 1187 14440000 228.700
           60) workingday>=0.500 834  7556000 206.700
            120) hour>=8.500 689  2394000 175.700
              240) hour< 15.500 598  1296000 163.100
                480) hour>=9.500 523  1097000 157.200
                  960) hour< 11.500 164   177800 130.100 *
                  961) hour>=11.500 359   742900 169.600 *
                481) hour< 9.500 75    56540 203.900 *
              241) hour>=15.500 91   375300 258.700
                482) month< 4.500 23    71790 202.500 *
                483) month>=4.500 68   206200 277.700 *
            121) hour< 8.500 145  1359000 353.900
              242) hour< 7.500 71   238600 275.700 *
              243) hour>=7.500 74   269700 428.900 *
           61) workingday< 0.500 353  5522000 280.700
            122) hour< 9.500 93   354200 114.100
              244) hour< 8.500 61    81430  77.640 *
              245) hour>=8.500 32    36530 183.700 *
            123) hour>=9.500 260  1664000 340.300
              246) temp< 0.550 45   377200 261.900 *
              247) temp>=0.550 215   952100 356.700
                494) hour< 10.500 30    30170 273.800 *
                495) hour>=10.500 185   682300 370.200
                  990) temp>=0.850 31    69710 293.300 *
                  991) temp< 0.850 154   392800 385.600 *
         31) hour>=16.500 484  7551000 359.200
           62) hour>=18.500 233  1453000 286.400
            124) hour>=19.500 115   463100 249.100
              248) temp< 0.630 33    97900 201.600 *
              249) temp>=0.630 82   260700 268.200 *
            125) hour< 19.500 118   674500 322.700
              250) workingday< 0.500 36   185800 270.200 *
              251) workingday>=0.500 82   346000 345.700 *
           63) hour< 18.500 251  3713000 426.800
            126) workingday< 0.500 77   619900 313.800
              252) hum>=0.585 27   259700 258.100 *
              253) hum< 0.585 50   230900 344.000 *
            127) workingday>=0.500 174  1675000 476.800
              254) month< 4.500 40   301700 387.200 *
              255) month>=4.500 134   956200 503.600
                510) hum>=0.695 23   251600 444.900 *
                511) hum< 0.695 111   608900 515.800 *
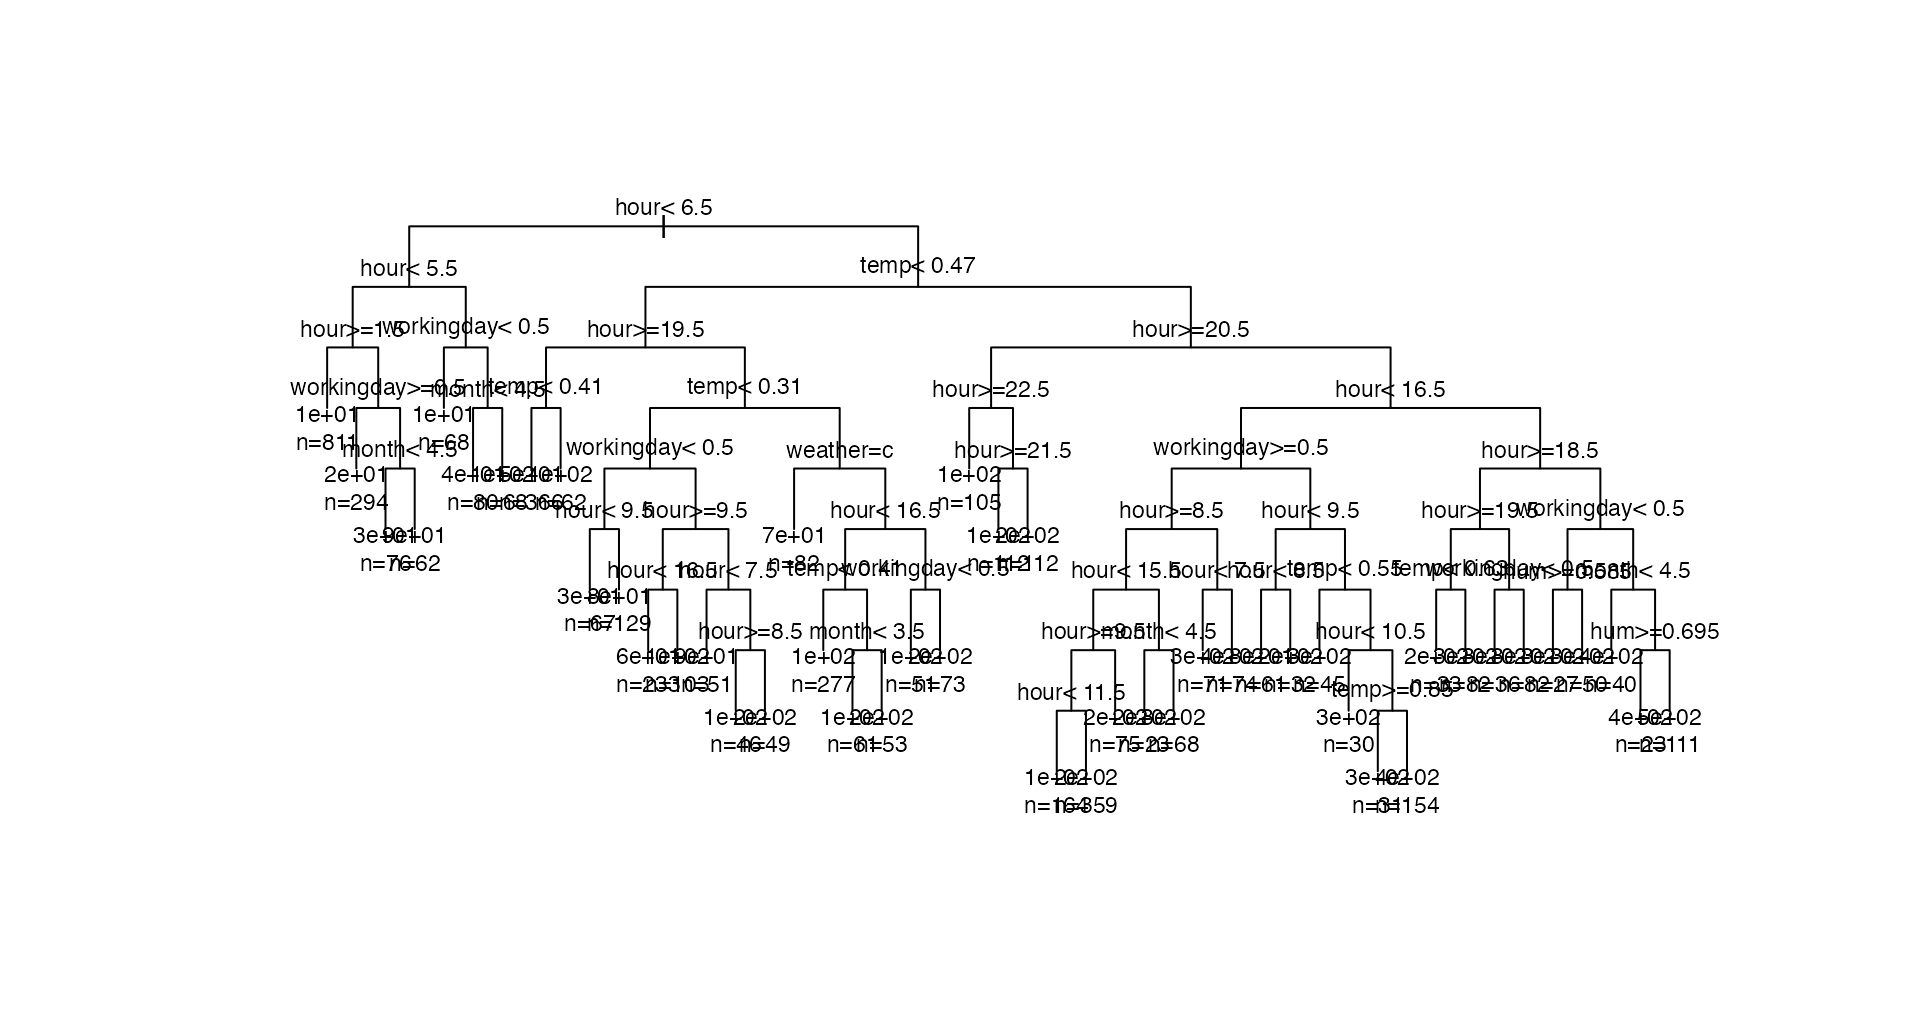
Visualizar las reglas
![]()
La figura representa una secuencia de decisiones, no una relación lineal promedio.
Complejidad y poda
Un árbol profundo suele tener bajo error de entrenamiento y alta varianza. La poda minimiza:
R_\alpha(T)=R(T)+\alpha|T|,
donde R(T) es el error del árbol y |T| su número de hojas.
cp controla el costo de agregar complejidad.
Poda por el eslabón más débil
Variar \alpha de 0 a \infty no genera todos los árboles posibles, sino una secuencia anidada única:
T_0 \supset T_1 \supset \cdots \supset \{\text{raíz}\}.
- En cada paso se colapsa el nodo interno con menor aumento de error por hoja (el “eslabón más débil”).
- Cada árbol de la secuencia es óptimo para un rango de \alpha.
- Elegimos \alpha (o
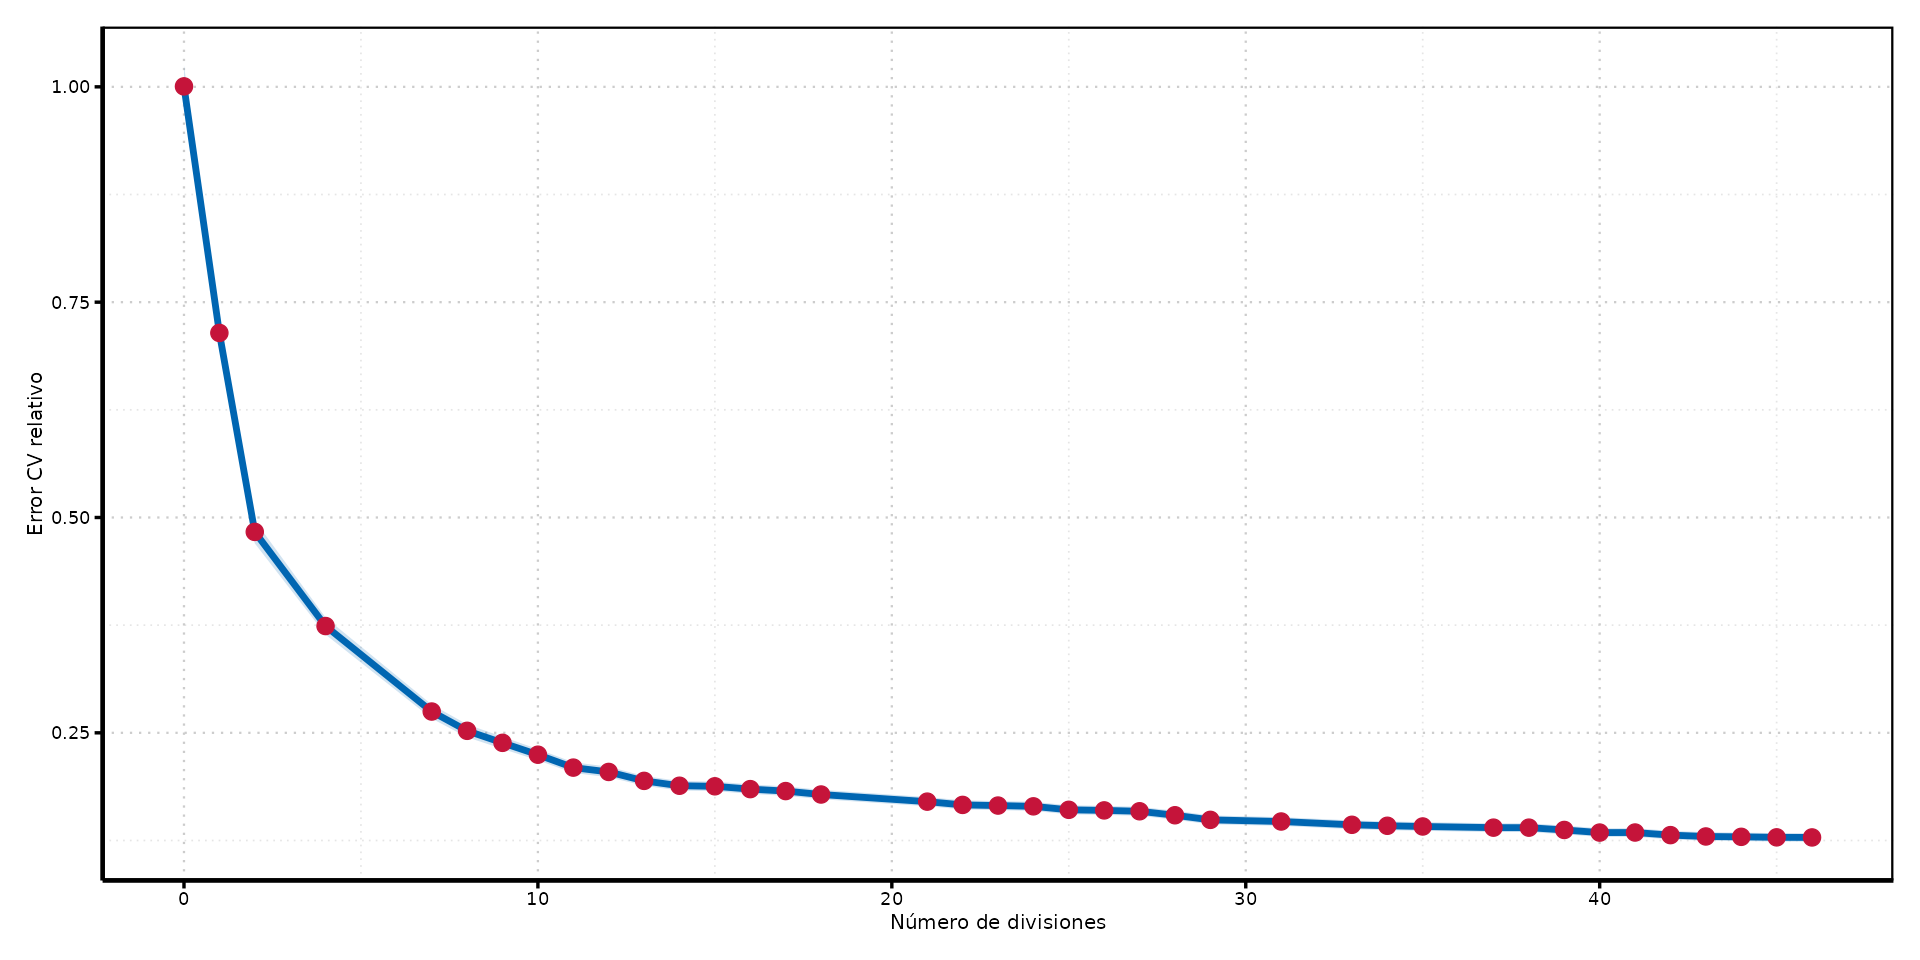
cp) por validación cruzada, con la regla de 1 error estándar: el árbol más pequeño dentro de 1 SE del mínimo.
- En
rpart, cp es \alpha reescalado por el error de la raíz; por eso es comparable entre problemas.
Elegir cp
# A tibble: 39 × 5
        cp splits relative_error cv_error   cv_se
     <dbl>  <dbl>          <dbl>    <dbl>   <dbl>
 1 0.286        0          1        1.000  0.024
 2 0.232        1          0.714    0.714 0.019
 3 0.056       2          0.481    0.483 0.013
 4 0.033       4          0.370    0.374 0.010
 5 0.027       7          0.271    0.275 0.008
 6 0.016       8          0.244    0.252 0.007
 7 0.011       9          0.228    0.238 0.007
 8 0.010     10          0.217    0.225 0.006
 9 0.008     11          0.207    0.210 0.006
10 0.007     12          0.199    0.205 0.006
# ℹ 29 more rows
Curva de poda
![]()
Desempeño de regresión
# A tibble: 1 × 3
  modelo        RMSE   MAE
  <chr>        <dbl> <dbl>
1 Árbol podado  82.400  55.300
Árbol de clasificación: ejemplo empírico
         predicho
observado baja alta
     baja 1109  178
     alta  197  264
Métricas de clasificación
# A tibble: 1 × 6
  umbral log_loss sensitivity specificity precision cost_per_100
   <dbl>    <dbl>       <dbl>       <dbl>     <dbl>        <dbl>
1   0.110    0.545       0.573       0.862     0.597         44.000
Las probabilidades de un árbol son constantes dentro de cada hoja. El umbral se eligió por costo en validación, no mirando test.
Una familia con nombres propios
rpart implementa una variante de CART (Classification and Regression Trees), el algoritmo que usamos hoy. No es el único:
| ID3 (1986) |
elige cortes solo por ganancia de información (entropía) |
| C4.5 / C5.0 |
extiende ID3: variables continuas, datos faltantes, poda integrada |
| CART (1984) |
Gini o SSE; produce árboles binarios; base de rpart y de Random Forest/Boosting |
Distintos nombres, misma lógica de fondo: particionar recursivamente para reducir impureza.
Ventajas y límites
Ventajas
- reglas fáciles de comunicar;
- no linealidades;
- interacciones automáticas;
- poca preparación de datos.
Límites
- divisiones inestables;
- predicción escalonada;
- alta varianza;
- un solo árbol suele predecir peor.
Por qué un árbol tiene alta varianza
- Los cortes son jerárquicos: cambiar el corte raíz reconfigura todo lo de abajo.
- La predicción es escalonada: constante por región, con saltos en los bordes.
- Muestras parecidas producen árboles distintos.
Esta inestabilidad es exactamente lo que atacan los ensambles: promediando (Random Forest) o corrigiendo por etapas (Boosting).
La intuición: un comité de árboles
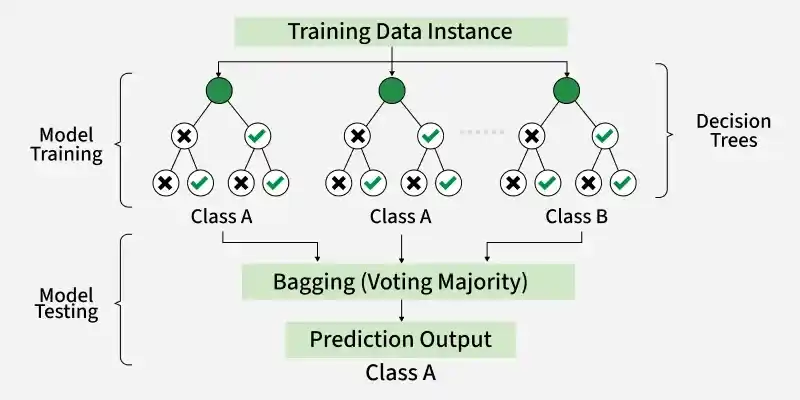
Un solo árbol es inestable: cambia mucho si cambia la muestra. La solución, propuesta por Leo Breiman (2001), es simple: en vez de confiar en un árbol, preguntarle a muchos y promediar.
![]()
Muchos árboles entrenados con datos ligeramente distintos “votan” y el bosque combina sus respuestas.
Es la misma lógica que consultar a varios expertos independientes en vez de a uno solo: los errores individuales tienden a cancelarse.
De un árbol a un bosque
Random Forest combina dos fuentes de aleatoriedad:
- Cada árbol recibe una muestra bootstrap.
- Cada nodo considera solo
mtry predictores candidatos.
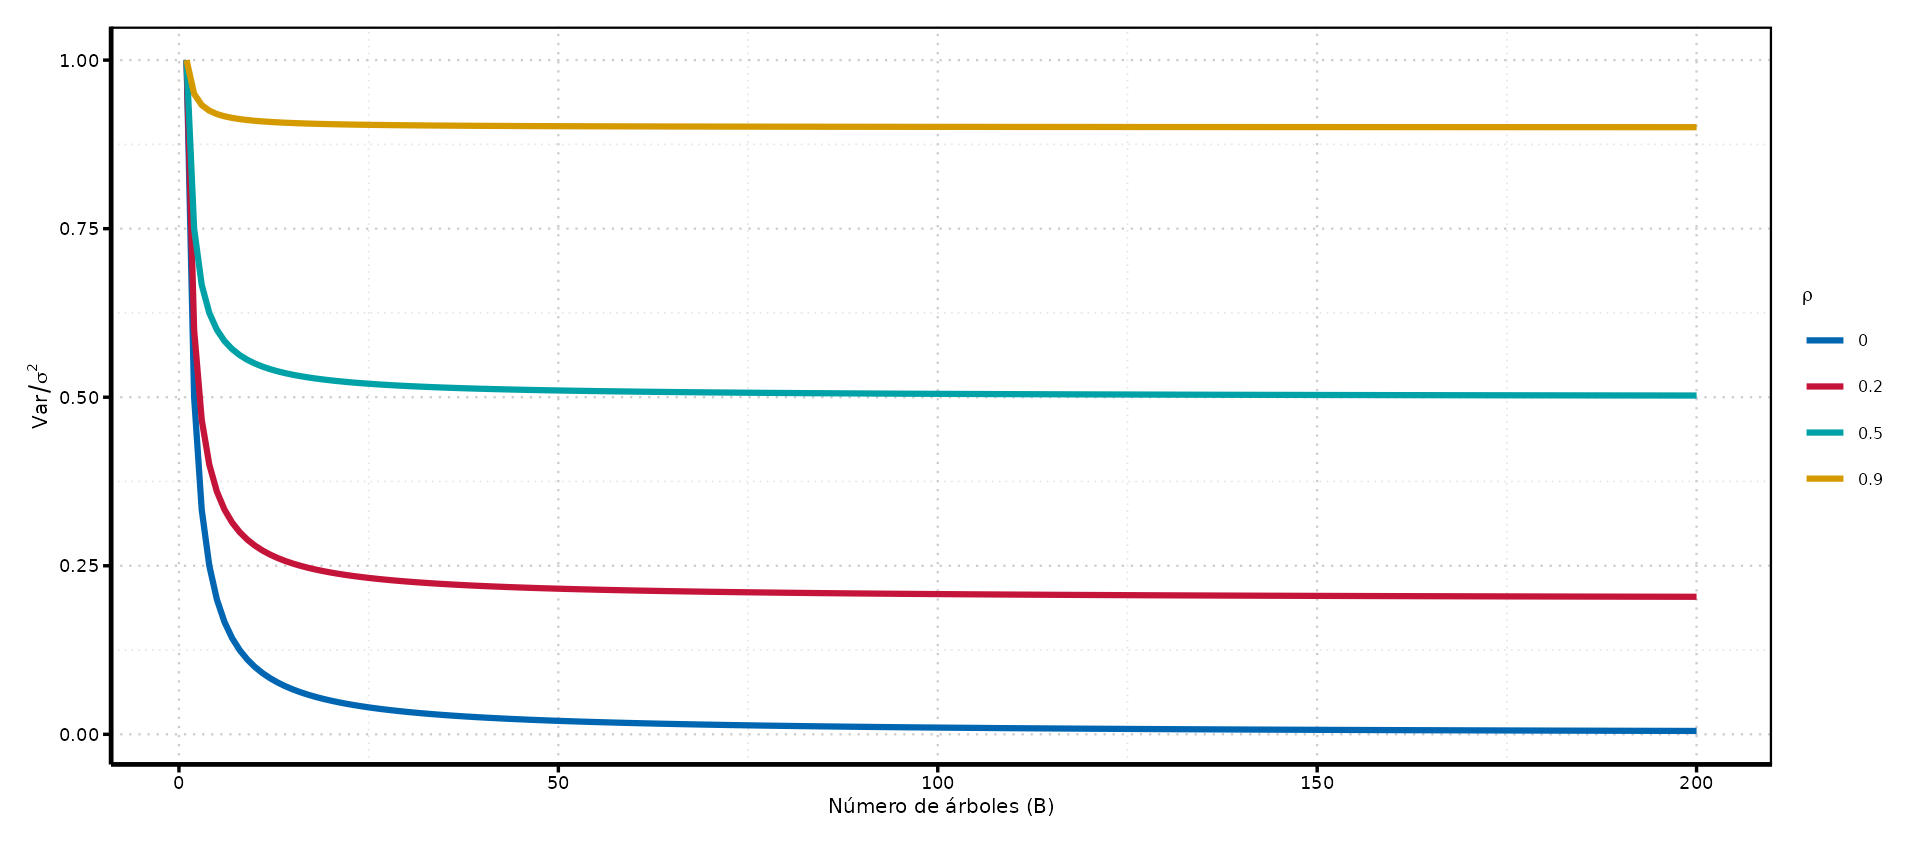
Promediar árboles poco correlacionados reduce varianza.
Algoritmo
Para b=1,\ldots,B:
- extraer una muestra bootstrap;
- crecer un árbol sin podar;
- sortear
mtry variables en cada nodo;
- guardar la predicción.
La probabilidad final es \hat p(x)=B^{-1}\sum_b\hat p_b(x).
Random Forest = bagging + decorrelación
Bagging usa bootstrap, que baja algo \rho. Random Forest además sortea mtry variables candidatas por nodo, lo que baja \rho mucho más.
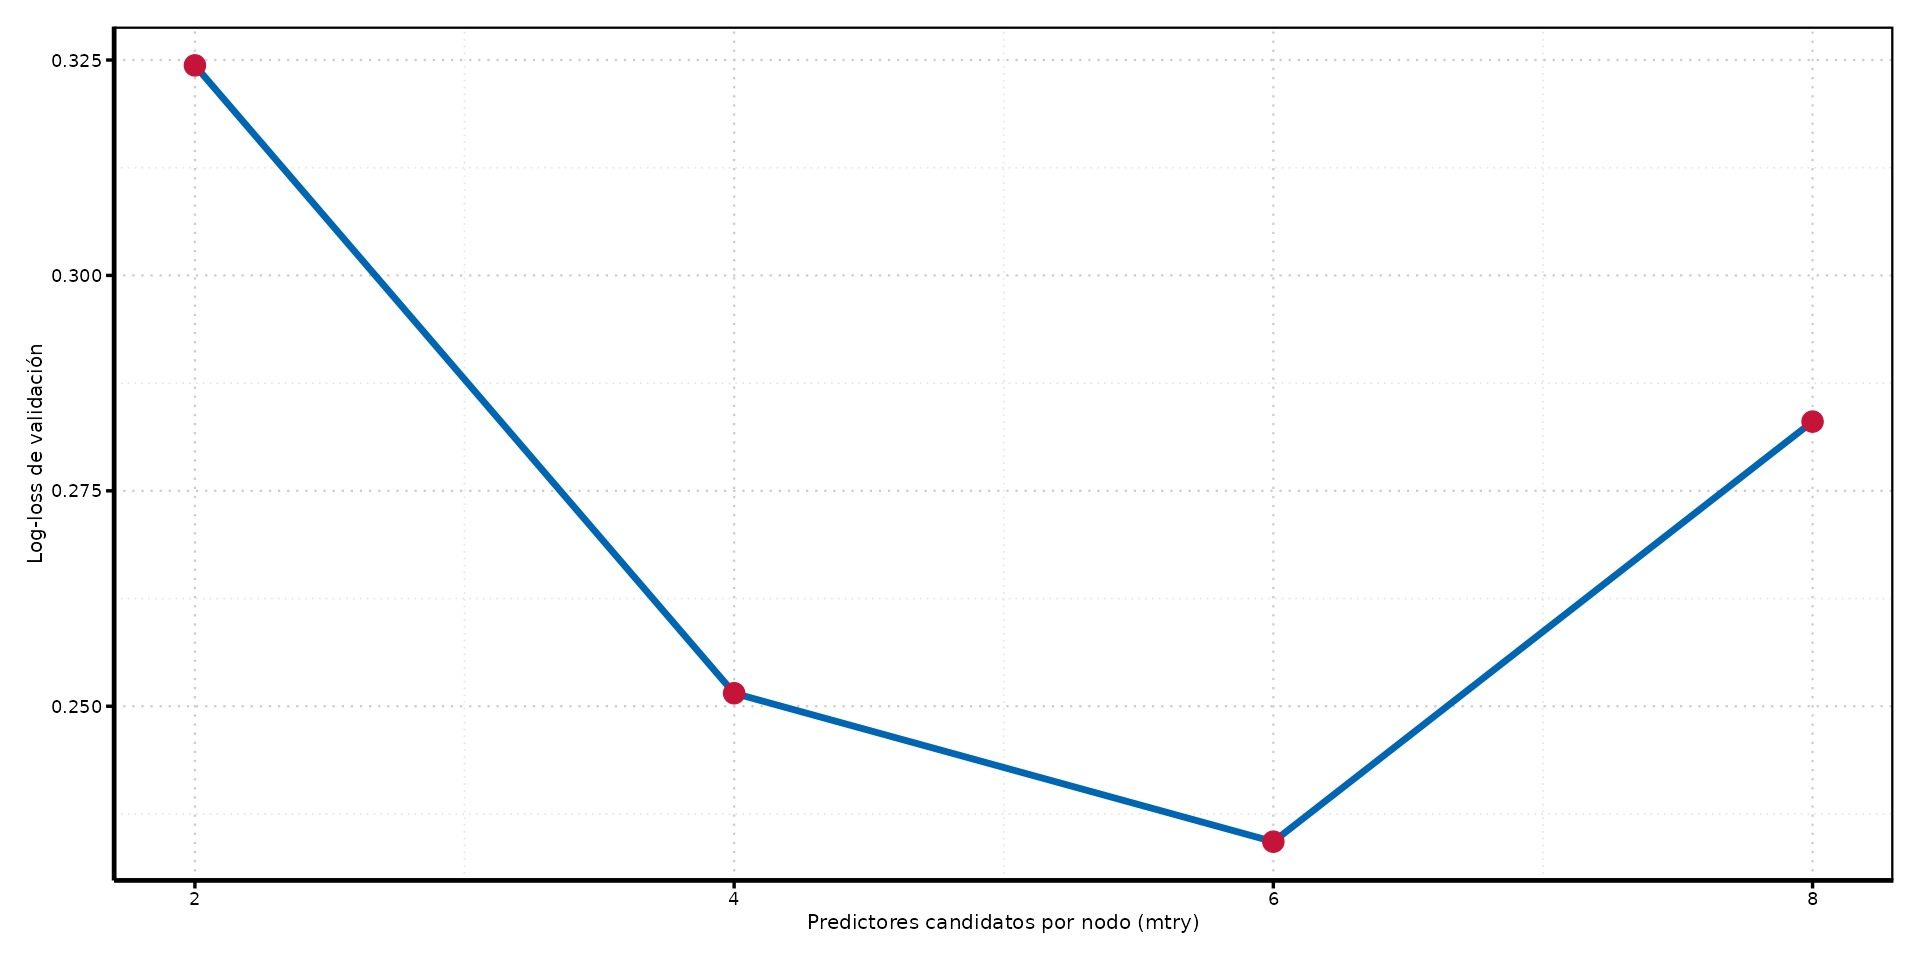
mtry chico → árboles menos correlacionados (piso más bajo), pero cada árbol algo más débil.mtry grande → árboles más fuertes pero más parecidos (piso más alto).- Es el dial que equilibra decorrelación y fuerza individual: por eso se elige con validación.
Tuning de mtry
# A tibble: 4 × 2
   mtry validation_loss
  <dbl>           <dbl>
1     2           0.324
2     4           0.252
3     6           0.234
4     8           0.283
Curva de validación
![]()
Random Forest: ejemplo empírico
# A tibble: 2 × 6
  modelo        log_loss sensitivity specificity precision cost_per_100
  <chr>            <dbl>       <dbl>       <dbl>     <dbl>        <dbl>
1 Árbol            0.545       0.573       0.862     0.597         44.000
2 Random Forest    0.294       0.944       0.772     0.597         21.300
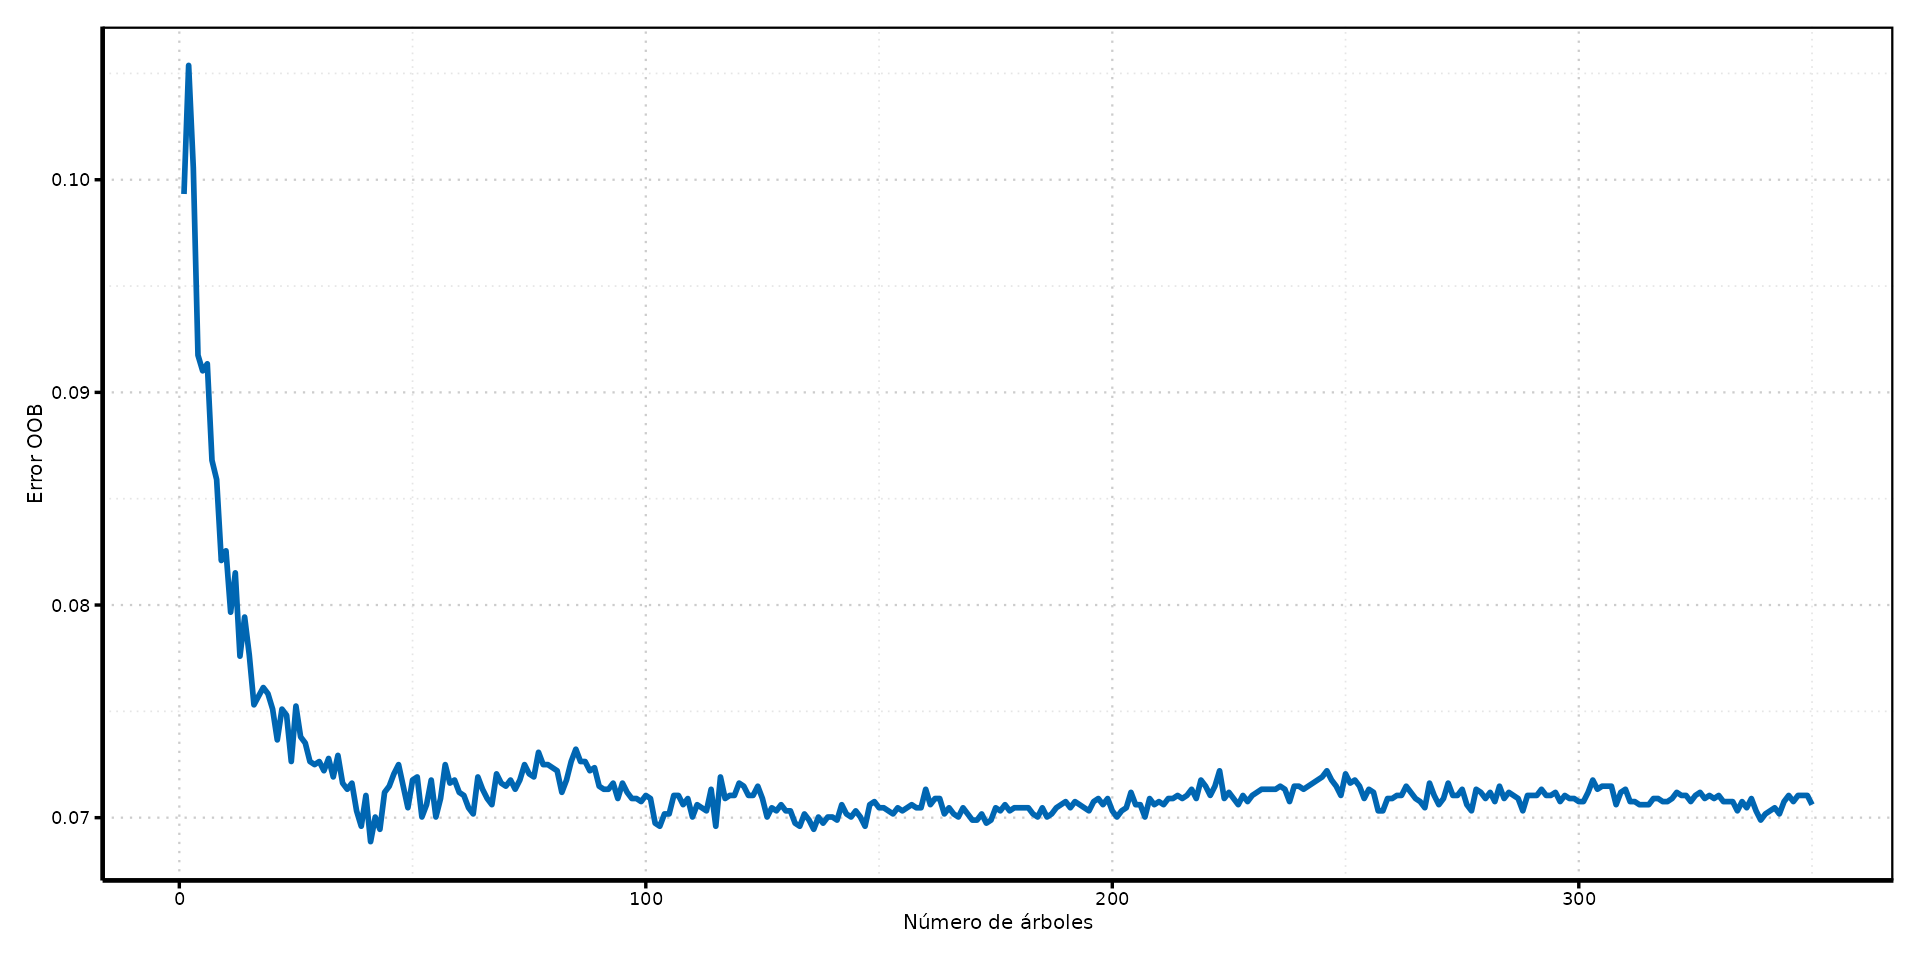
Error out-of-bag
![]()
Cada observación queda fuera de aproximadamente un tercio de los bootstrap. El error OOB permite verificar si agregar árboles todavía estabiliza el bosque; no reemplaza el test final.
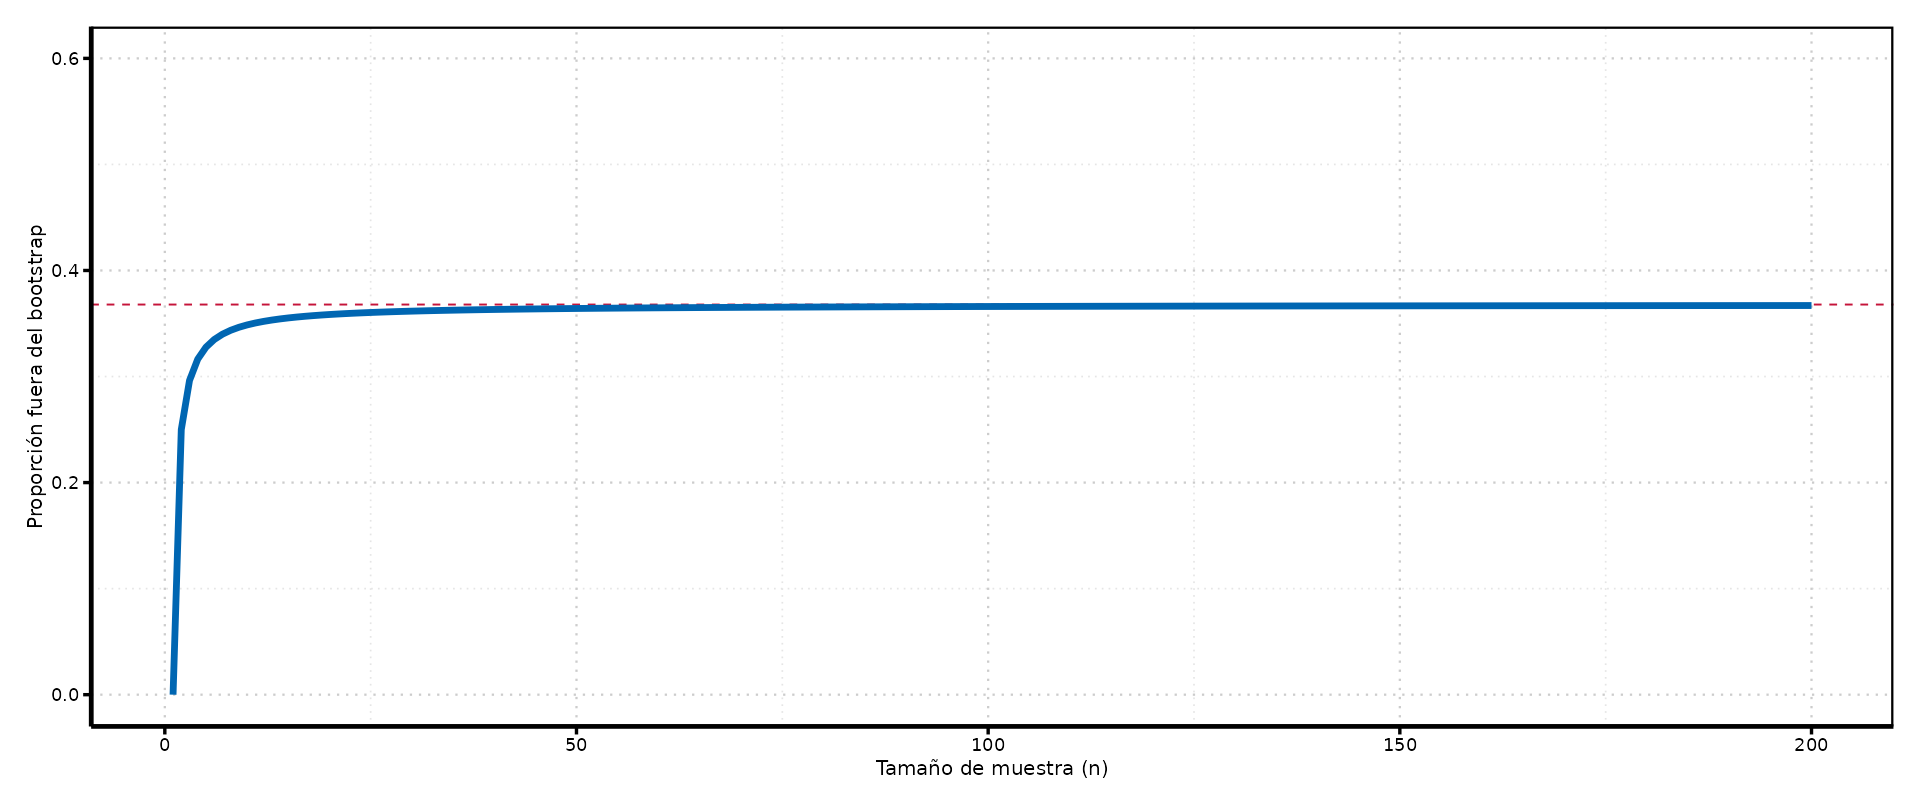
De dónde sale el 36.8 %
La probabilidad de que una observación no entre en una muestra bootstrap de tamaño n es:
\left(1-\frac1n\right)^{n}\;\xrightarrow[n\to\infty]{}\;e^{-1}\approx 0.368.
![]()
Predecir cada observación con los árboles que no la vieron da el error OOB: una validación incorporada, casi gratis.
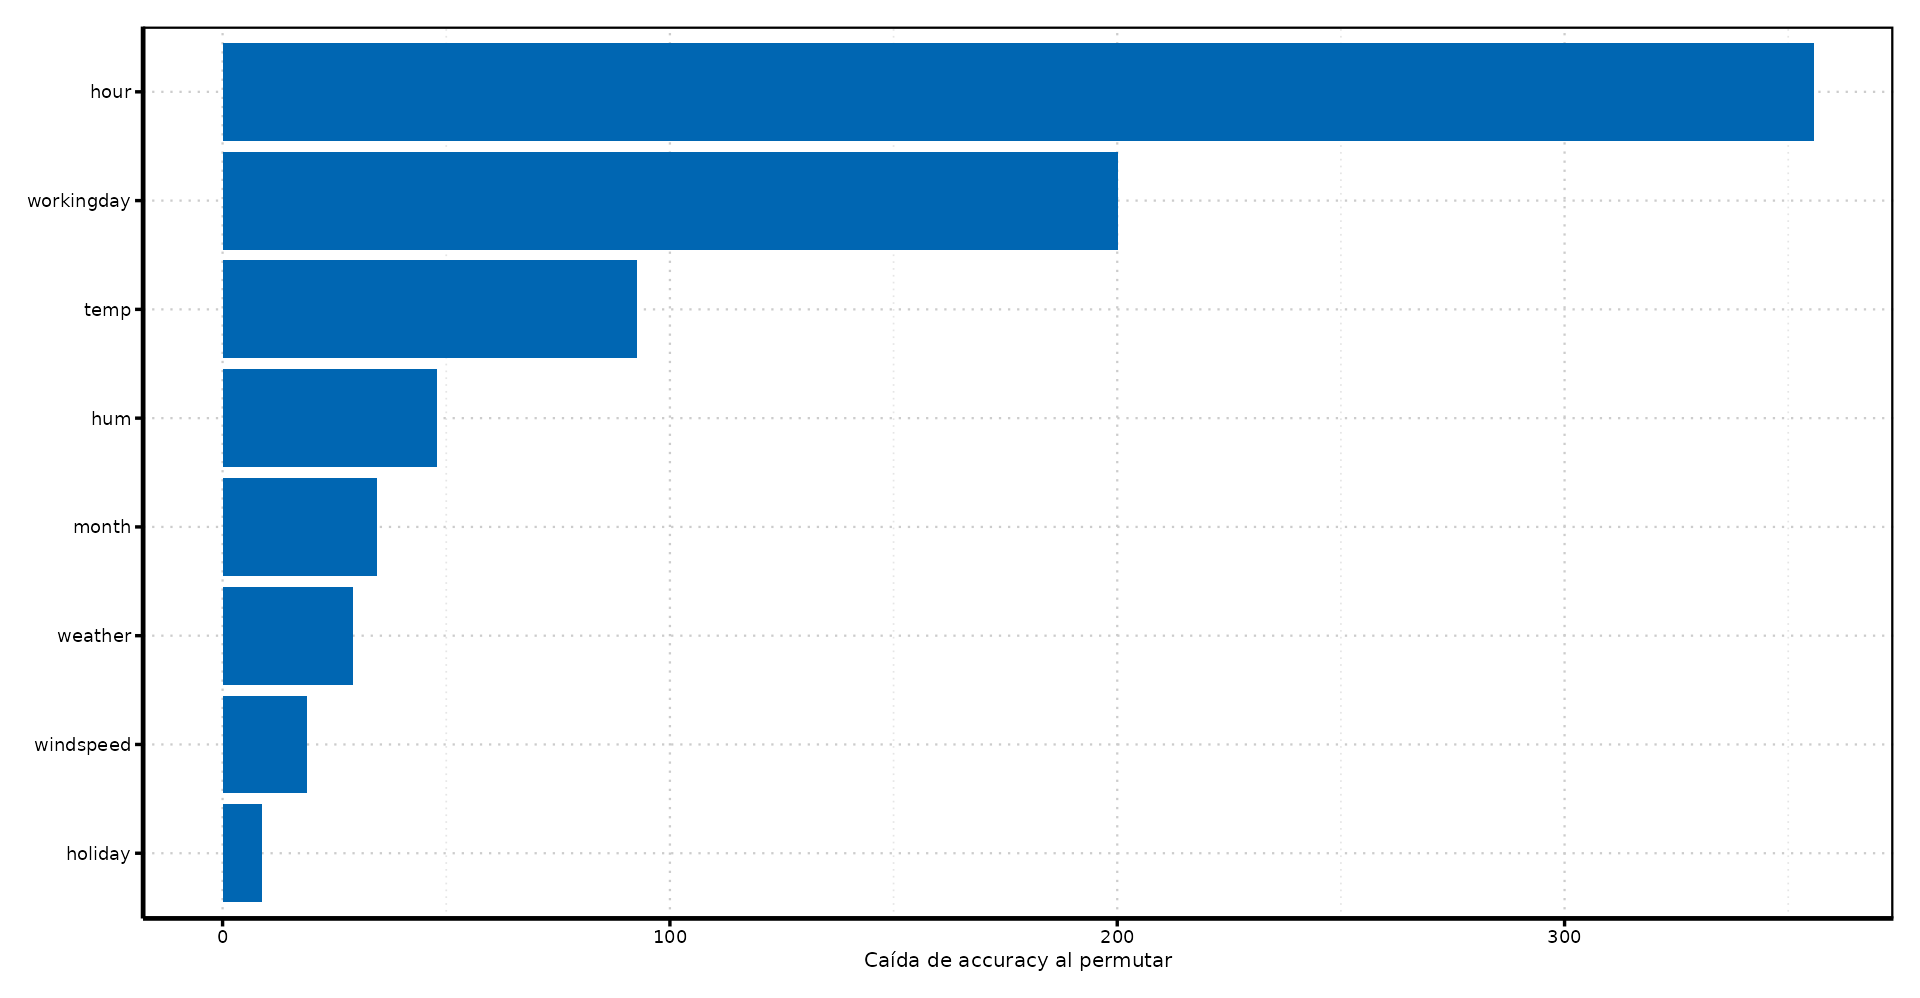
Importancia por permutación
![]()
La importancia no es causal
- Variables correlacionadas pueden compartir importancia.
- Una variable con muchos puntos de corte puede resultar favorecida.
- La importancia mide aporte predictivo dentro de este modelo.
- No identifica el efecto de intervenir sobre una variable.
Use la importancia para diagnosticar el predictor, no para reemplazar teoría.
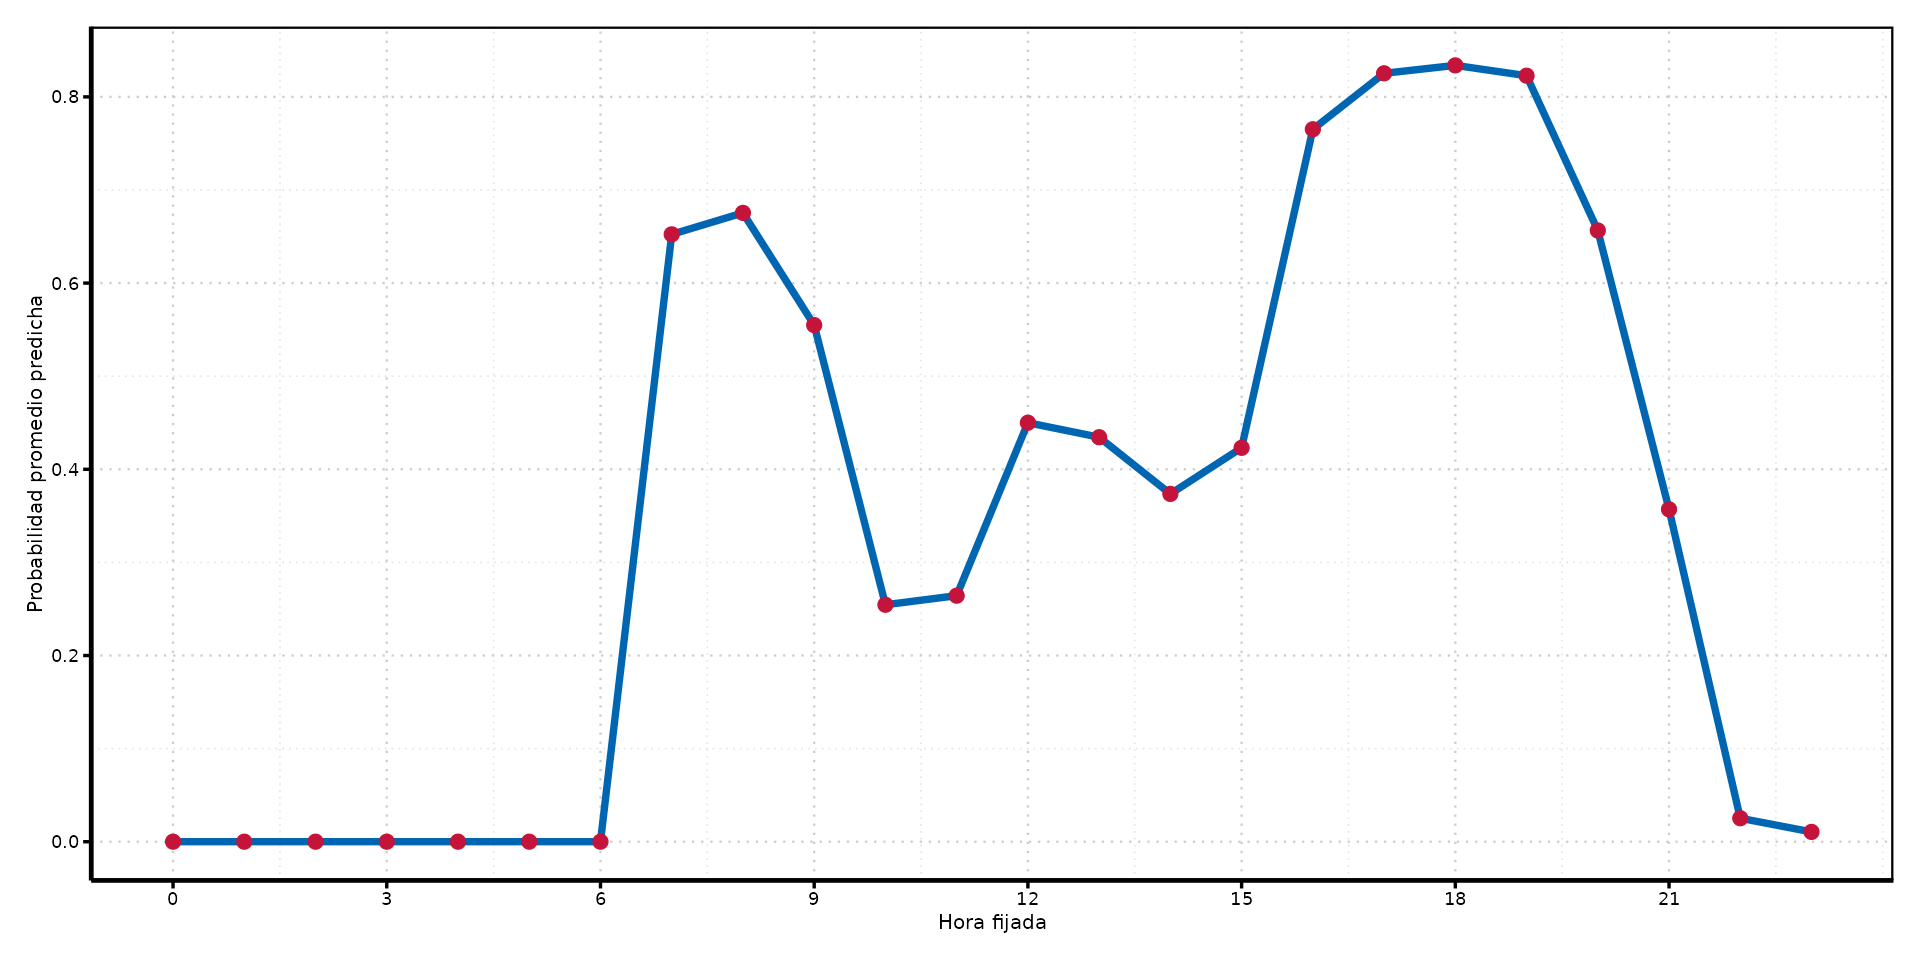
Perfil de demanda alta por hora
![]()
Es una descripción del modelo; supone que podemos fijar la hora manteniendo el resto de las filas.
Aprender secuencialmente
La intuición de boosting es la de aprender de los propios errores: en vez de promediar árboles independientes, entrenamos uno a la vez y cada nuevo árbol se concentra en lo que el ensamble actual todavía predice mal.
Formalmente, agrega árboles pequeños, cada uno concentrado en los errores del ensamble actual:
\widehat f_M(x)=\widehat f_{M-1}(x)+\nu h_M(x).
- h_M: árbol débil.
- \nu: tasa de aprendizaje.
- M: número de árboles.
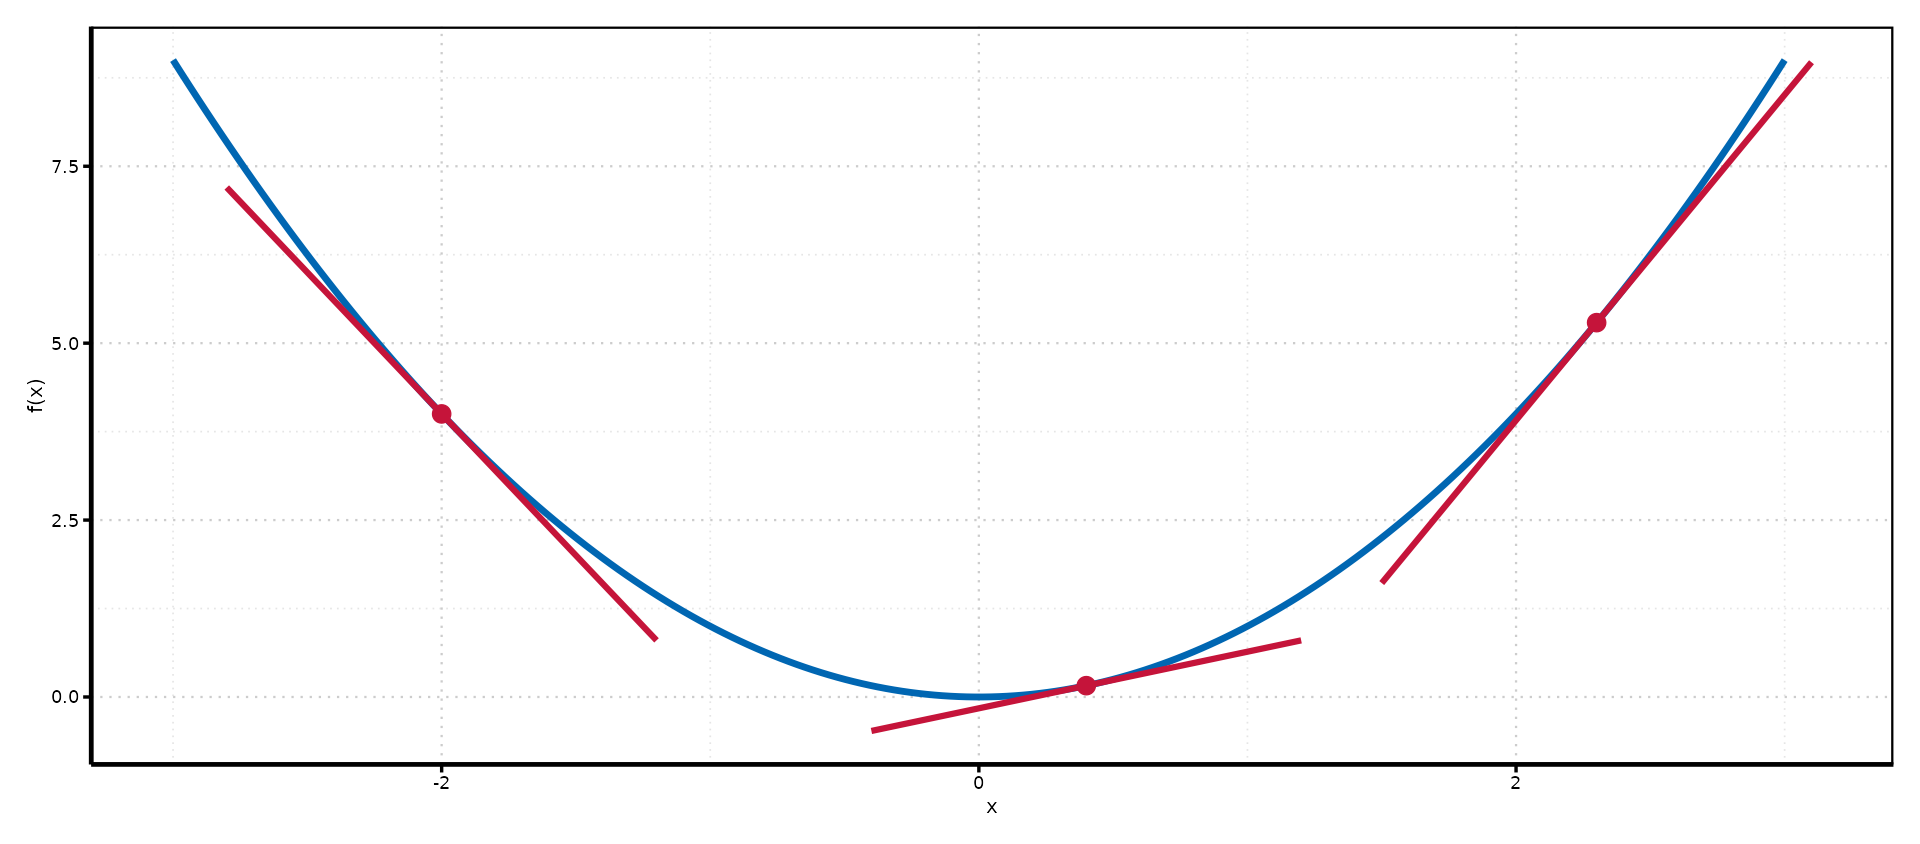
¿Qué es un gradiente?
El gradiente de una función f es el vector de sus derivadas parciales, \nabla f(x) = \left(\frac{\partial f}{\partial x_1}, \dots, \frac{\partial f}{\partial x_p}\right). En una sola dimensión, es simplemente la pendiente de la tangente: f'(x).
![]()
- La pendiente (el gradiente) indica cuánto y en qué dirección cambia f en ese punto.
- Apunta hacia donde f crece más rápido; su negativo, -\nabla f, apunta hacia donde f decrece más rápido — hacia el mínimo.
- “Descender por el gradiente” es, literalmente, dar pasos pequeños en la dirección -\nabla f hasta acercarse a un mínimo de f.
Esta idea reaparecerá hoy (boosting) y en la próxima clase (redes neuronales) — cada vez que se mencione, un recordatorio breve como este acompañará la lámina.
Boosting como descenso de gradiente
En la etapa m, boosting ajusta un árbol al gradiente negativo de la pérdida y da un paso:
\widehat f_m(x)=\widehat f_{m-1}(x)+\nu\, h_m(x),
\qquad
h_m \approx -\left[\frac{\partial L}{\partial f}\right]_{f=\widehat f_{m-1}}.
Es descenso de gradiente en el espacio de funciones: cada árbol es un paso que corrige el error actual.
En clasificación, el gradiente es y-p
Con pérdida logística Bernoulli y score f(x_i):
-\frac{\partial L}{\partial f(x_i)}
=y_i-\sigma(f(x_i))
=y_i-p_i.
- Cada árbol se ajusta a la diferencia entre la clase observada y la probabilidad actual.
- Un falso negativo seguro tiene y_i-p_i\approx1: recibe una corrección grande.
- Con pérdida cuadrática el gradiente sería el residuo y_i-f(x_i): mismo principio, distinta pérdida.
- Por eso boosting reduce sesgo: corrige sistemáticamente lo que el modelo aún no captura.
La tasa de aprendizaje regulariza
\widehat f_m=\widehat f_{m-1}+\nu\,h_m,\qquad 0<\nu\le 1.
- \nu pequeño = pasos cortos: menos sobreajuste, pero se necesitan más árboles M — la combinación se elige junto, no cada parámetro por separado.
- La profundidad de cada árbol fija el orden de interacción (stumps = modelo aditivo, sin interacciones).
bag.fraction < 1 (submuestreo) añade aleatoriedad y baja varianza: stochastic gradient boosting.- Demasiados árboles, con \nu alto, sí puede sobreajustar — a diferencia de Random Forest.
Bagging versus boosting
| Ajuste |
árboles en paralelo |
árboles secuenciales |
| Objetivo principal |
reducir varianza |
reducir sesgo |
| Árbol típico |
profundo |
pequeño |
| Regularización |
mtry, tamaño de hoja |
profundidad, \nu, M |
| Sensibilidad a outliers |
baja (el promedio los diluye) |
alta (cada etapa persigue el error anterior) |
Sesgo y varianza en los ensambles
| Sesgo |
bajo |
bajo |
se reduce por etapas |
| Varianza |
alta |
baja (promedio) |
controlada por \nu,M |
| Ataca sobre todo |
— |
varianza |
sesgo |
| Riesgo principal |
sobreajuste |
escaso |
sobreajuste si M alto |
Random Forest raramente sobreajusta al agregar árboles; boosting sí puede, porque cada árbol nuevo reduce el error de entrenamiento.
Tuning del boosting
# A tibble: 6 × 3
  depth shrinkage validation_log_loss
  <dbl>     <dbl>               <dbl>
1     3      0.080               0.235
2     2      0.080               0.283
3     3      0.030               0.305
4     2      0.030               0.357
5     1      0.080               0.364
6     1      0.030               0.424
Gradient Boosting: ejemplo empírico
# A tibble: 3 × 6
  modelo            log_loss sensitivity specificity precision cost_per_100
  <chr>                <dbl>       <dbl>       <dbl>     <dbl>        <dbl>
1 Árbol                0.545       0.573       0.862     0.597         44.000
2 Random Forest        0.294       0.944       0.772     0.597         21.300
3 Gradient Boosting    0.279       0.896       0.850     0.682         19.300
Cada método conserva su umbral elegido en validación bajo el mismo costo 3:1. La comparación final usa las mismas filas y el mismo outcome.
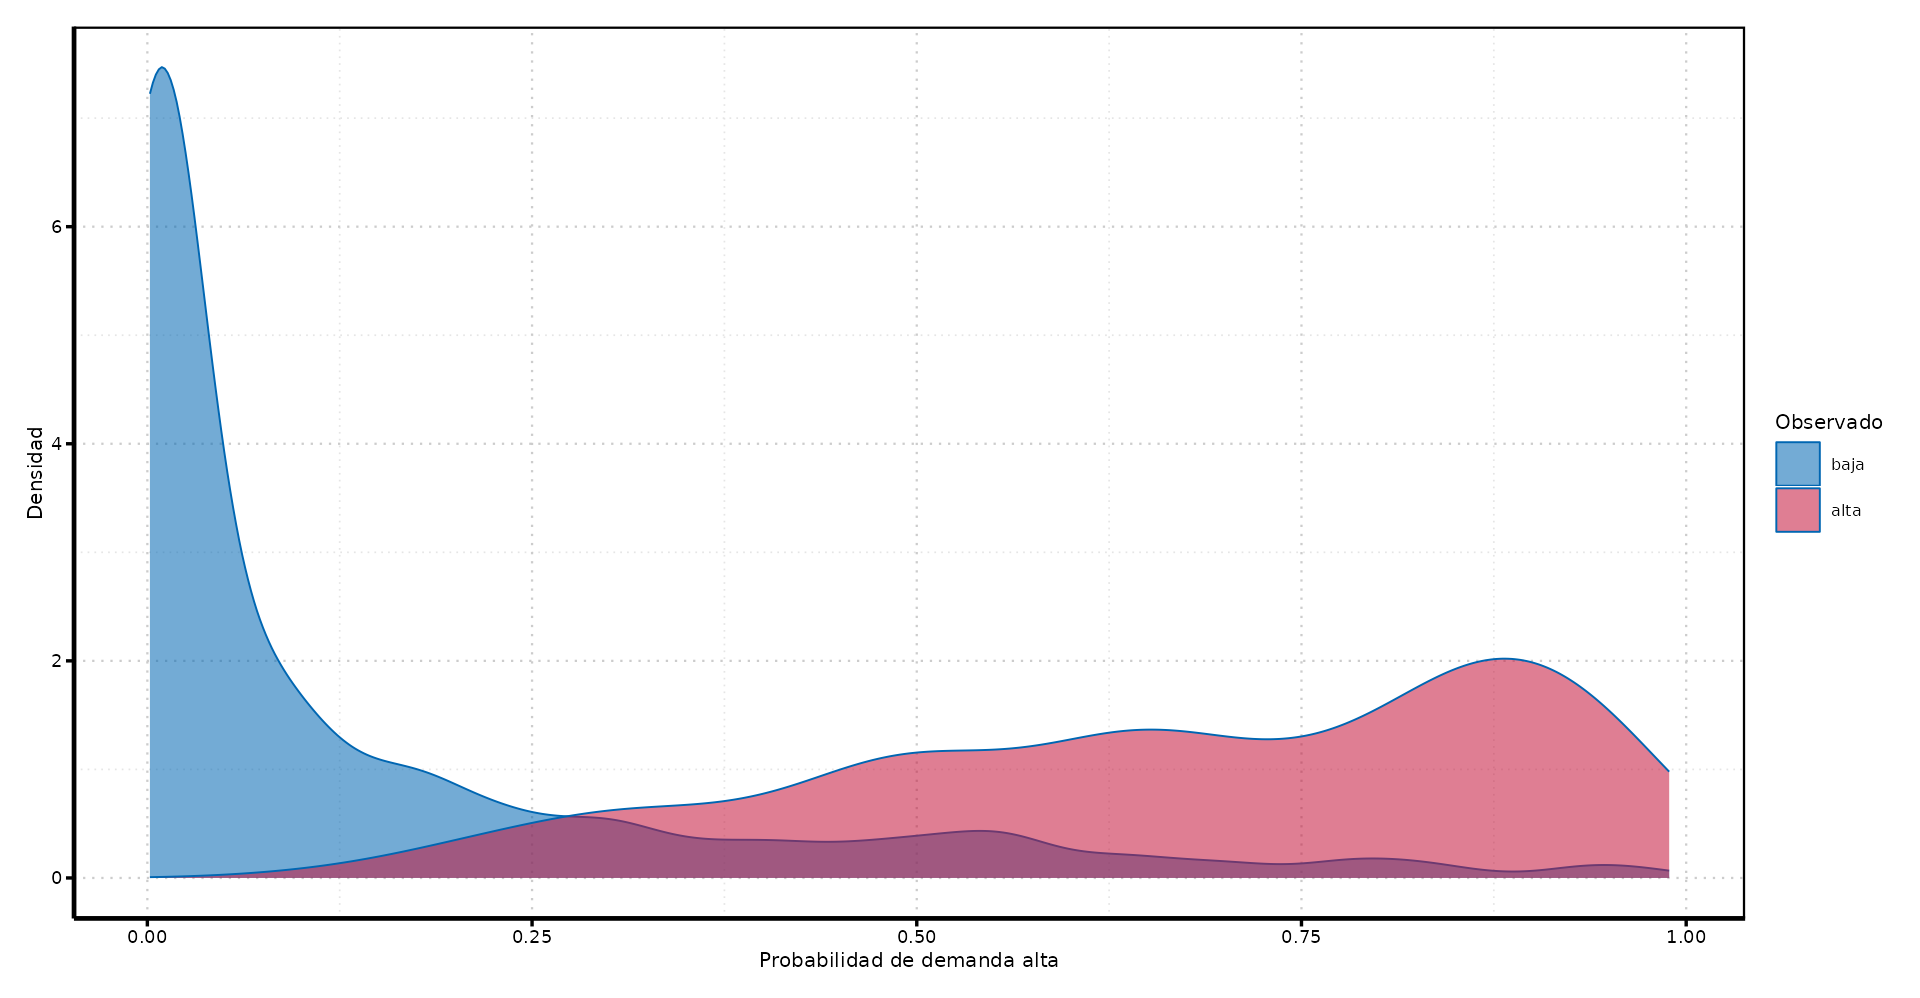
Probabilidades por resultado observado
![]()
Mayor separación indica mejor ranking, pero la decisión final también depende de calibración y costo.
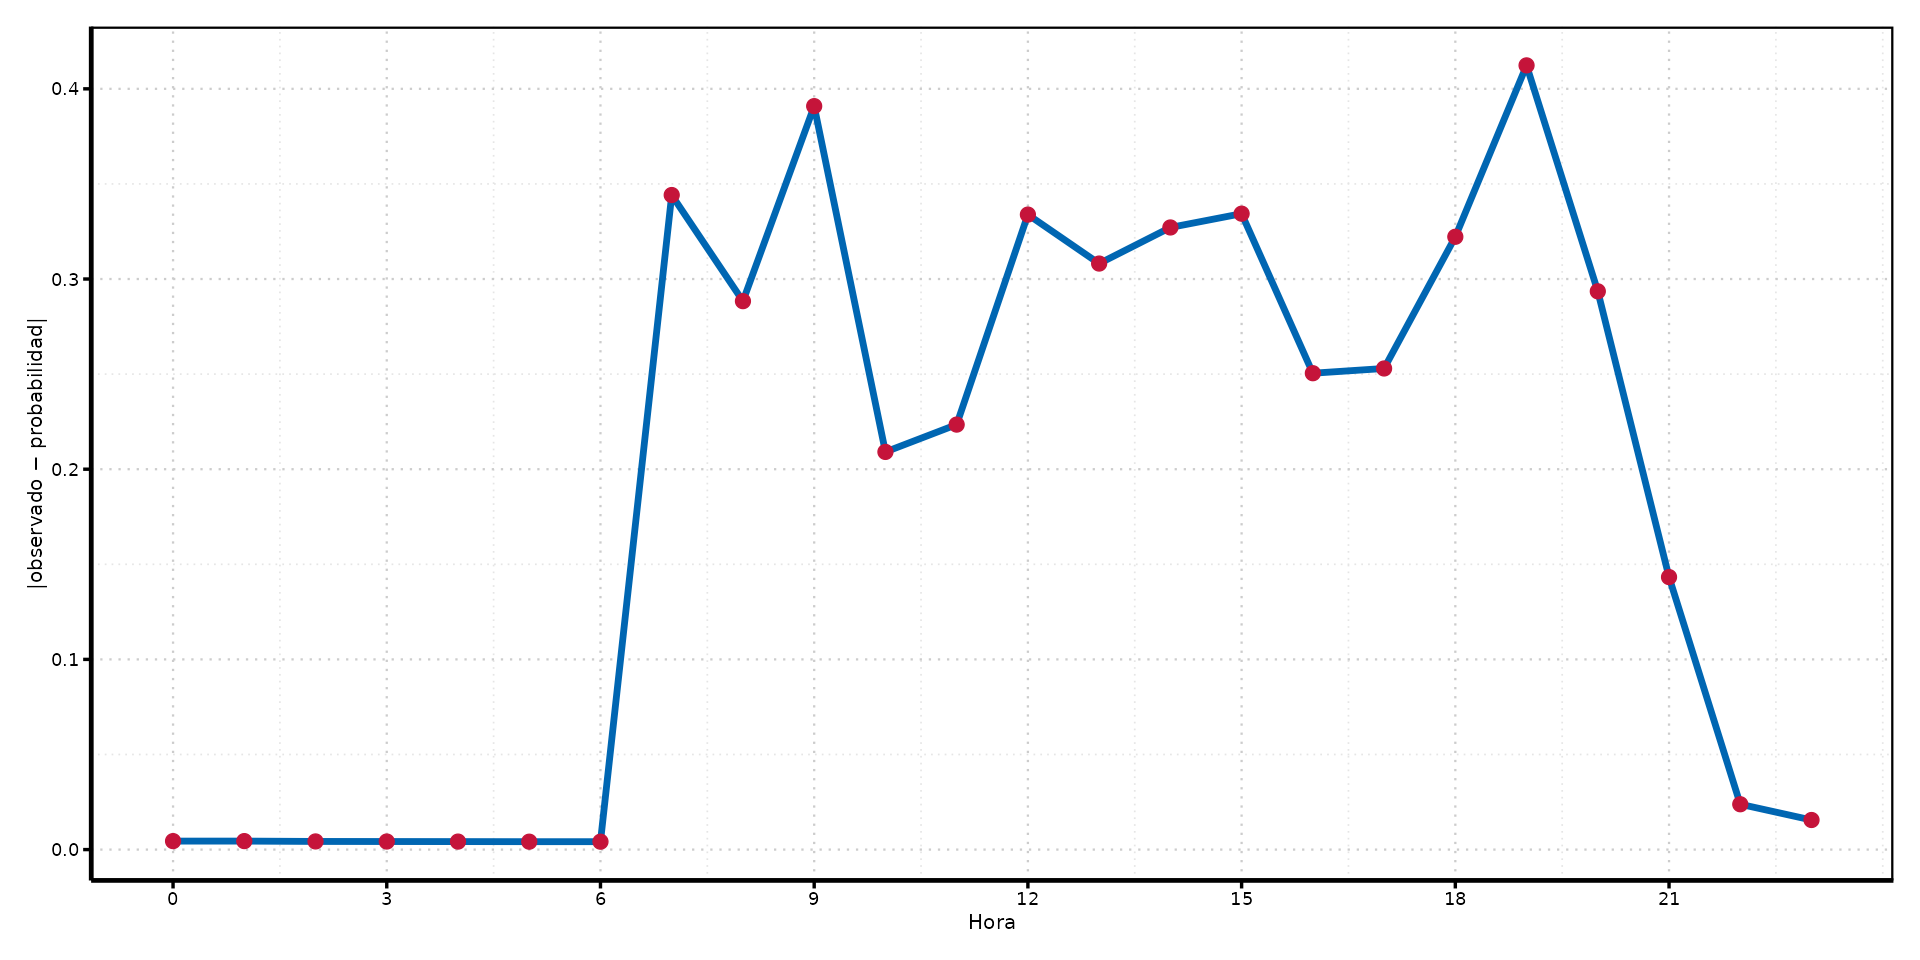
Error de probabilidad por hora
![]()
Patrones persistentes indican franjas donde el ensamble todavía no captura toda la estructura.
Una predicción del ensamble, de punta a punta
# A tibble: 1 × 10
    día  hora temperatura profundidad tasa_aprendizaje probabilidad umbral acción    demanda_observada clase_observada
  <dbl> <int>       <dbl>       <dbl>            <dbl>        <dbl>  <dbl> <chr>                 <dbl> <fct>
1   298    17        0.560           3             0.080        0.989   0.340 priorizar               585 alta
El ensamble aprende la forma; el protocolo conserva trazabilidad sobre qué fila recibió qué score y qué acción.
Más allá de gbm
gbm es pedagógico: implementa la idea de boosting con claridad, pero en la práctica se usan versiones optimizadas:
- XGBoost: gradient boosting con regularización explícita sobre los árboles y paralelización — el estándar de facto en competencias y producción con datos tabulares.
- LightGBM: variante orientada a velocidad en datasets grandes.
- Stacking: una tercera familia de ensambles, distinta de bagging y boosting — entrena varios modelos distintos (p. ej. logit, Random Forest, boosting) y un meta-modelo aprende a combinar sus predicciones.
La lógica de fondo —combinar modelos simples para predecir mejor que cualquiera por separado— no cambia; cambia la implementación.
Otros casos de uso
Árboles y ensambles son, junto con los GLM, el caballo de batalla de datos tabulares en la práctica:
| Salud |
árboles de decisión clínica (reglas de diagnóstico interpretables) |
| Finanzas |
detección de fraude y scoring de crédito con Gradient Boosting |
| Marketing |
segmentación de clientes y predicción de churn con Random Forest |
| Biología |
clasificación de especies e identificación de genes relevantes |
| Búsqueda / ranking |
los motores de búsqueda usan variantes de boosting para ordenar resultados |
En todos los casos, el atractivo es el mismo que motivó la clase de hoy: capturar no linealidades e interacciones sin tener que especificarlas a mano.