Un nuevo módulo, una nueva pregunta
Durante todo el curso, cada modelo (LPM, logit, Poisson) compartió un mismo supuesto: nosotros elegimos qué variables entran, qué interacciones importan, qué transformaciones usar. El modelo solo estima los coeficientes.
Las clases 16–18 exploran una pregunta distinta: ¿qué pasa cuando dejamos de confiar en que esa forma elegida a mano sea la correcta? ¿Puede el propio procedimiento de ajuste decidir cuánta complejidad usar — o incluso qué forma tomar?
Referencia principal para las tres clases: James et al. (2021), An Introduction to Statistical Learning, 2ª ed., capítulos 5–6, 8 y 10 (sitio oficial).
La solicitud predictiva no cambia
Al cierre de cada día, estimar qué horas del día siguiente tendrán demanda alta, para priorizar el rebalanceo de bicicletas.
| Unidad y horizonte |
una hora, hasta 24 horas |
| Target |
sobre el percentil 75 aprendido en train |
| Información |
calendario, hora y pronóstico meteorológico |
| Costo |
falso negativo = 3; falso positivo = 1 |
| Evaluación |
partición temporal 60/20/20 |
Hoy no cambiamos la pregunta para favorecer al método. Cambiamos solo cómo se controla una matriz de predictores amplia y correlacionada.
El problema, en carne propia
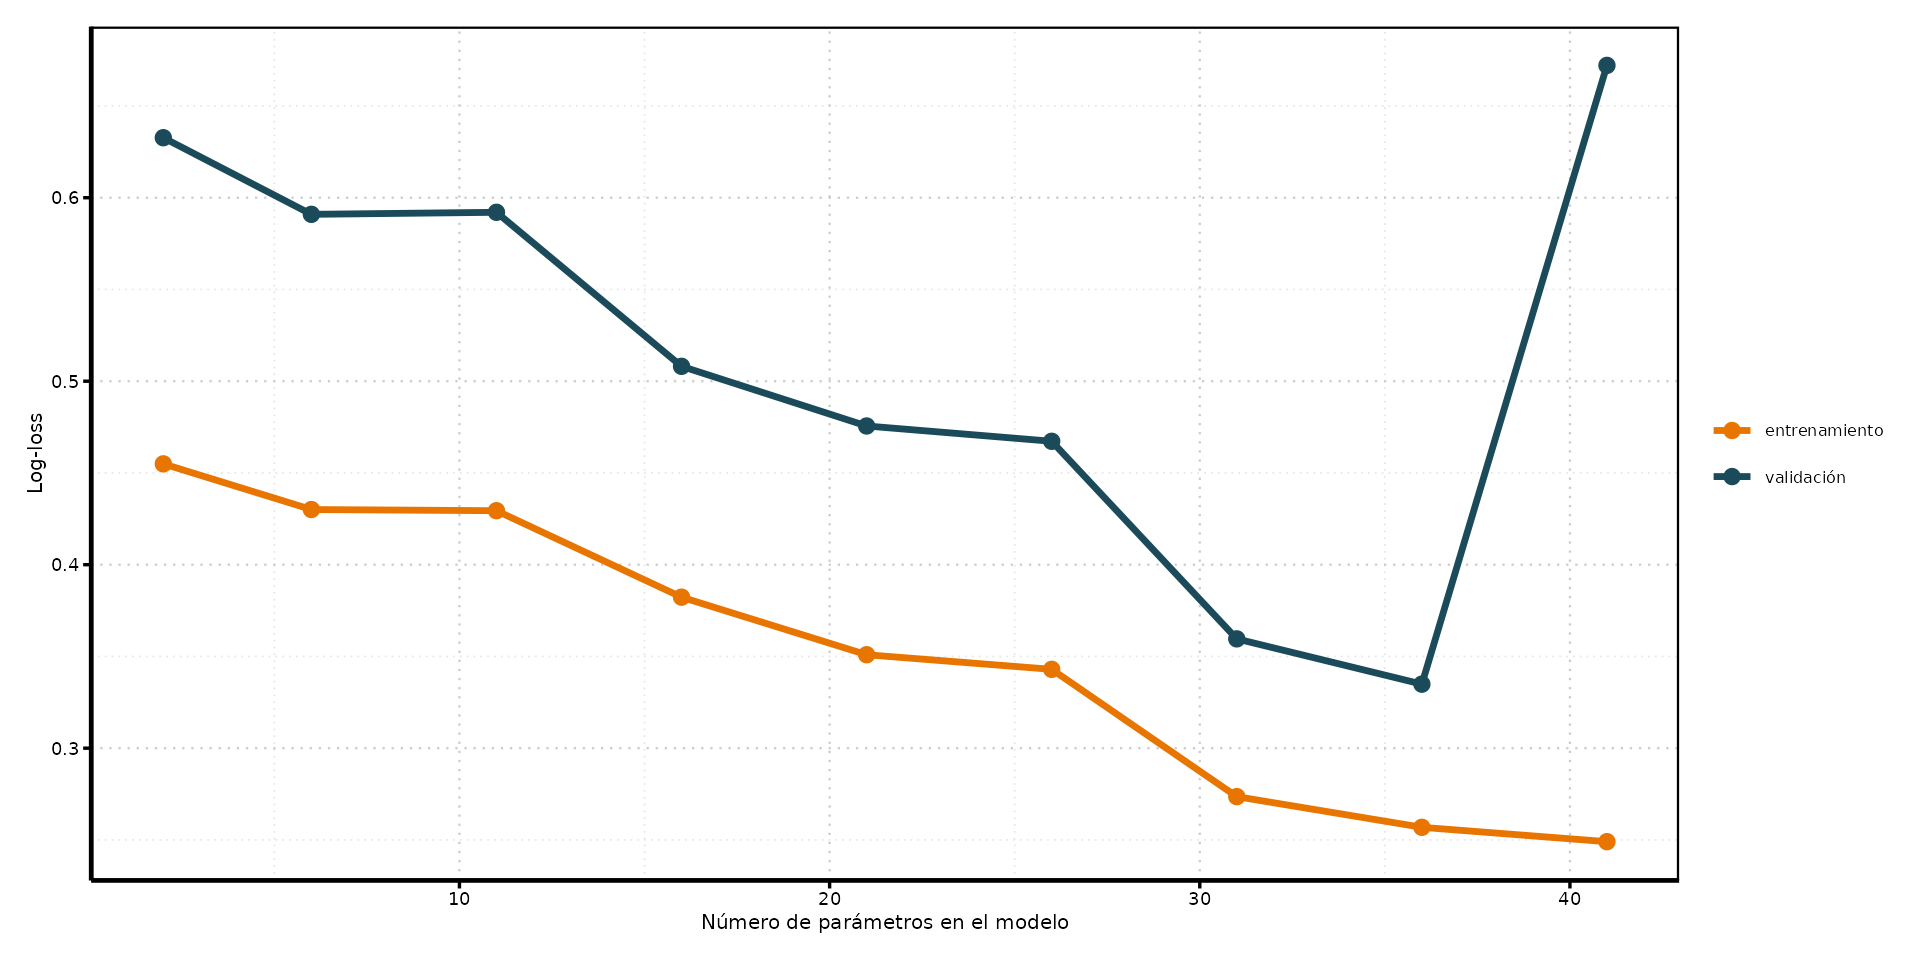
Sigamos usando la misma pregunta sustantiva del curso — ¿cuándo hay demanda alta de bicicletas? — pero démosle al logit una interacción completa entre hora (24 categorías) y mes (12 categorías): mucho más flexible que la interacción hora × día hábil que usamos hasta ahora. Agreguemos esas variables de a poco y observemos qué pasa.
![]()
Leer la curva
- Con pocos parámetros, ambos errores bajan juntos: el modelo aprende señal real (temperatura, hora, clima).
- Pasado cierto punto, el error de entrenamiento sigue bajando —más parámetros siempre ajustan mejor esos datos— pero el de validación empieza a subir: el modelo empieza a ajustar celdas hora×mes con pocas observaciones, memorizando ruido específico de esa combinación particular.
- Este divorcio entre “ajusta mejor” y “predice mejor” es el problema que motiva toda la clase de hoy.
Nótese algo importante: no sabíamos de antemano cuál de estas variables hora×mes era señal y cuál era ruido — todas entraron con la misma justificación teórica (“la demanda varía por hora y por estación”). Hasta ahora controlábamos la complejidad a mano, decidiendo qué interacciones incluir. La pregunta de hoy es si el propio procedimiento de ajuste puede controlar esa complejidad automáticamente, de forma validada.
Intuición: sesgo y varianza
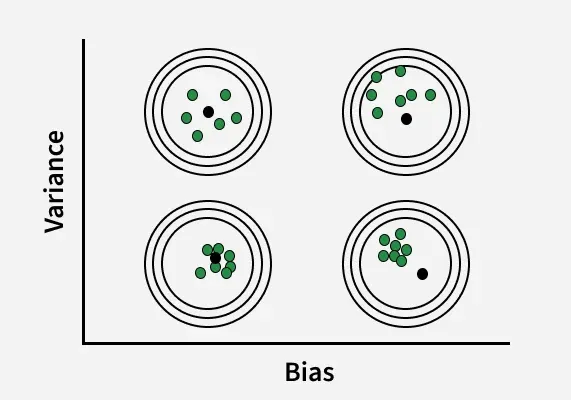
Antes de la solución, pongamos nombre al fenómeno que acabamos de ver, con una analogía simple.
![]()
Sesgo = qué tan lejos del centro caen los tiros en promedio. Varianza = qué tan dispersos están entre sí.
- Pocos parámetros (modelo rígido): los tiros caen agrupados, pero lejos del centro — sesgo alto.
- Muchos parámetros (modelo flexible): los tiros rodean el centro en promedio, pero dispersos — varianza alta.
- Nuestra curva de arriba es exactamente esto: pocos parámetros = sesgo (mal ajuste, en train y en validación); muchos parámetros = varianza (ajusta train, falla en validación).
El compromiso, en una imagen
![]()
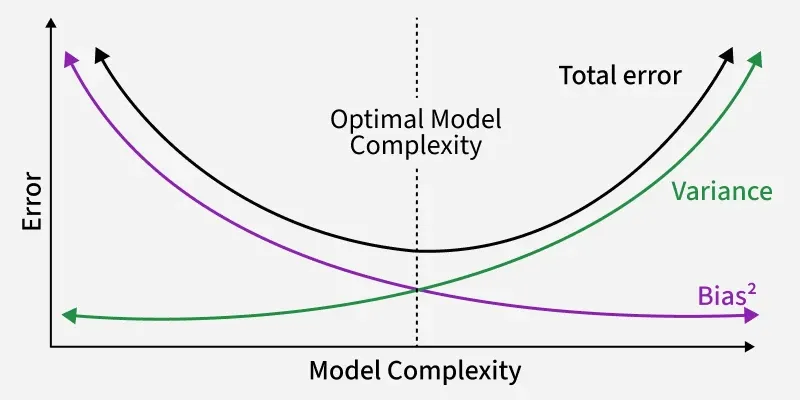
Sesgo, varianza y error total en función de la complejidad del modelo.
- \lambda=0 (sin penalizar): sesgo bajo, varianza alta → la mitad derecha de nuestra curva de validación.
- \lambda\to\infty: sesgo alto, varianza baja → subajuste.
- Existe un \lambda^{*} intermedio que minimiza el error fuera de muestra — no lo conocemos, lo estimamos con validación.
Configuración: outcome y partición
El módulo completo (clases 15–18) comparte la misma preparación de datos. Primero definimos el outcome y partimos los datos:
Configuración: la matriz de diseño
Sobre esos datos construimos la matriz de predictores X que usarán Ridge, LASSO y Elastic Net:
El diseño de datos de hoy
# A tibble: 1 × 3
  observaciones_train variables_base columnas_modelo
                <int>          <dbl>           <int>
1                5162              9              60
La expansión incluye no linealidad en clima, indicadores de calendario e interacción hora × día hábil — exactamente el tipo de términos que, en la curva de arriba, empujaba el modelo hacia el sobreajuste. temp y atemp son además deliberadamente casi idénticas: veremos que ese tipo de colinealidad es precisamente donde Ridge resulta más útil.
Tres conjuntos, tres funciones
Antes de penalizar nada, fijemos la disciplina de evaluación — ya la usamos antes (bootstrap, validación) pero aquí es central, no un anexo:
| Entrenamiento |
60% |
estimar coeficientes |
| Validación |
20% |
elegir \alpha y \lambda |
| Test |
20% |
estimar desempeño final, una sola vez |
Mirar el test durante el tuning produce filtración de información: el desempeño deja de ser genuinamente fuera de muestra — el mismo problema, en miniatura, que acabamos de ver en la curva de sobreajuste.
# A tibble: 3 × 4
  conjunto      primer_día último_día horas
  <chr>              <dbl>      <dbl> <int>
1 Entrenamiento          1        219  5162
2 Validación           220        292  1735
3 Test                 293        365  1748
Entrenamos con el pasado, elegimos hiperparámetros en un período posterior y reservamos los últimos días para test: una partición aleatoria sería optimista si horas vecinas comparten patrones no observados.
Motivación: cuando los predictores se parecen entre sí
temp y atemp están altamente correlacionadas. En un GLM sin penalizar, esto genera un problema específico: X^\top X se vuelve casi no invertible, y pequeños cambios en la muestra producen coeficientes muy distintos — alta varianza, tal como vimos arriba.
Ridge ataca exactamente ese síntoma: en vez de dejar que los coeficientes crezcan sin control para “explicar” la colinealidad, los penaliza por tamaño.
Intuición: el estimador como compromiso
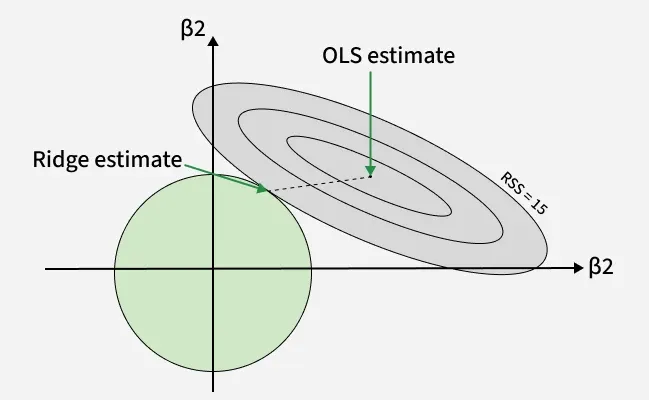
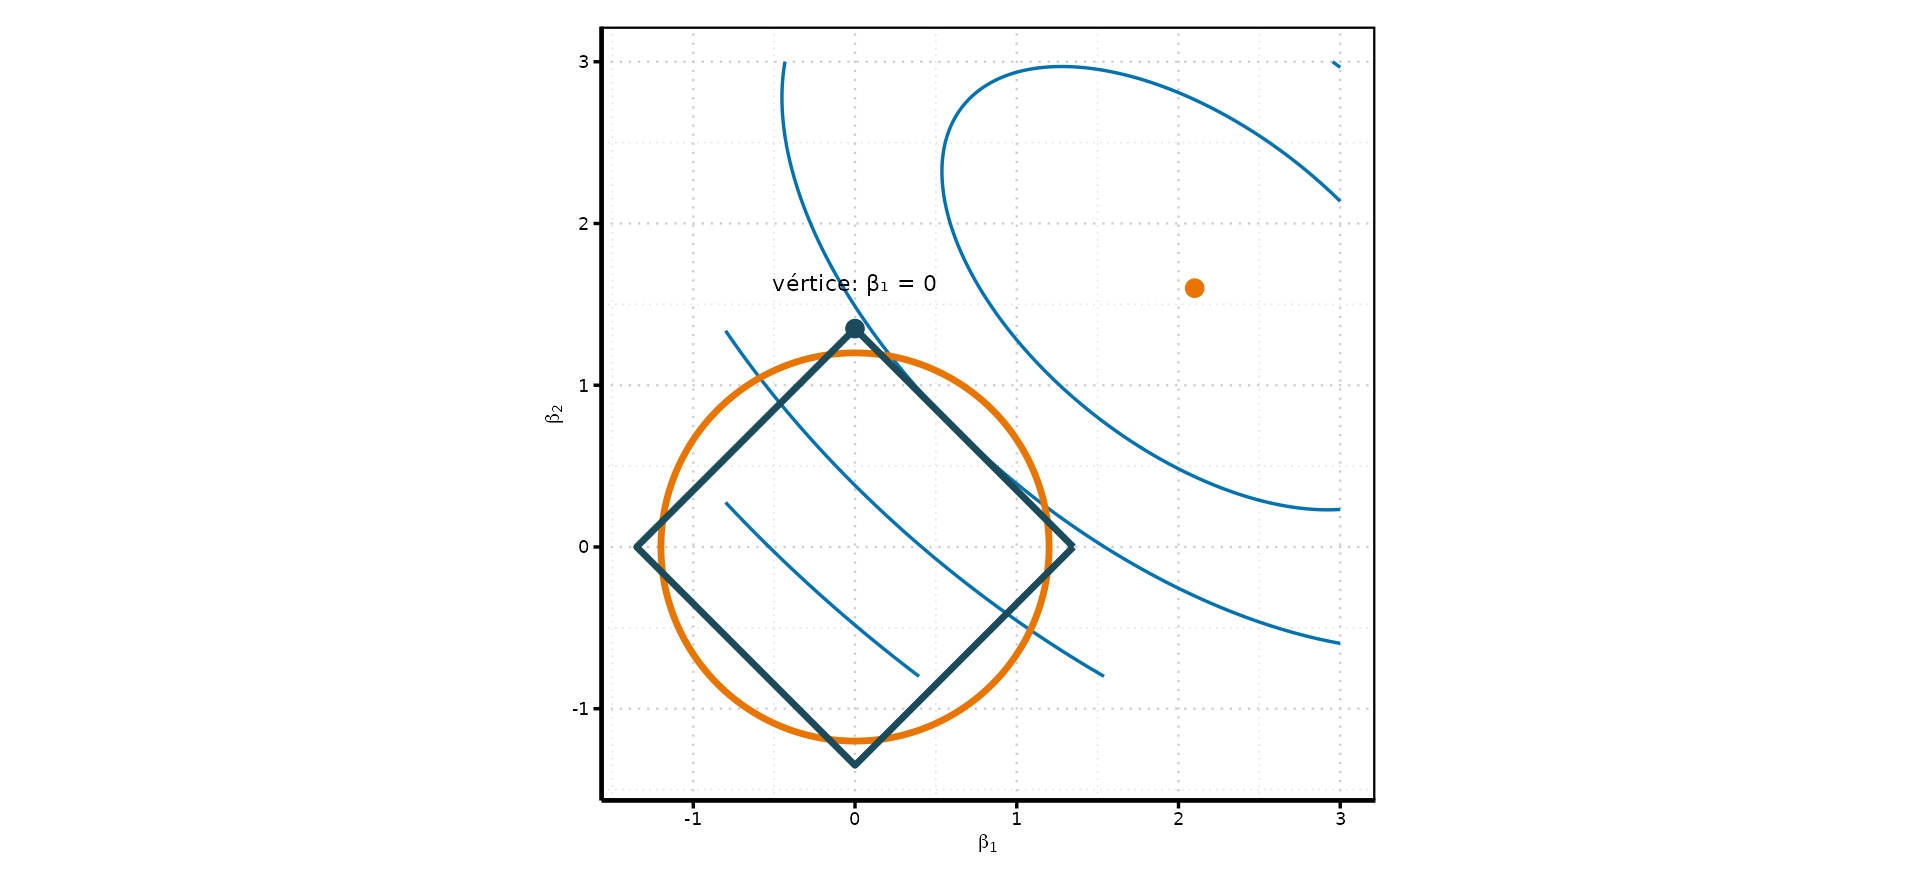
En la geometría familiar de mínimos cuadrados, agregar una penalización por el tamaño de \boldsymbol\beta es “tirar” al estimador hacia el origen, un poco menos lejos de donde los datos solos lo llevarían.
![]()
El estimador Ridge (verde) es el punto donde las curvas de nivel de la pérdida (elipses) tocan primero la región de restricción circular.
La verosimilitud que penalizamos
Con log-odds \eta_i=\beta_0+x_i^\top\boldsymbol\beta y p_i=\sigma(\eta_i):
\ell(\boldsymbol\beta)=\sum_{i=1}^{n}\big[\,y_i\,\eta_i-\log(1+e^{\eta_i})\,\big].
- y_i\in\{0,1\}: demanda alta observada.
- \eta_i: log-odds predicho; p_i=\sigma(\eta_i): probabilidad predicha — el mismo logit de las clases 9 a 11.
- Maximizar \ell equivale a minimizar la devianza -2\ell.
Minimizar -\ell+\lambda P(\boldsymbol\beta) es, entonces, “ajustar bien las probabilidades sin coeficientes desmesurados”.
Descomposición matemática: solución cerrada
En regresión lineal, Ridge tiene solución explícita — útil para ver qué hace la penalización:
\widehat{\boldsymbol\beta}^{\text{ridge}}=(X^\top X+\lambda I)^{-1}X^\top y.
- Sumar \lambda I vuelve invertible a X^\top X aunque haya colinealidad casi perfecta (
temp y atemp) — resuelve exactamente el problema que motivó esta técnica.
- \lambda=0 recupera mínimos cuadrados; \lambda\to\infty lleva \widehat{\boldsymbol\beta}\to 0.
- En regresión logística no hay fórmula cerrada, pero la misma penalización +\lambda I estabiliza cada paso del ajuste iterativo (IRLS).
Descomposición matemática: qué hace Ridge, dirección por dirección
Con la descomposición X=UDV^\top (columnas estandarizadas), las predicciones Ridge se contraen dirección por dirección:
\widehat y=\sum_{j}u_j\,\frac{d_j^{2}}{d_j^{2}+\lambda}\,u_j^\top y.
- d_j: valor singular de la dirección j — cuánta varianza tiene esa combinación de predictores.
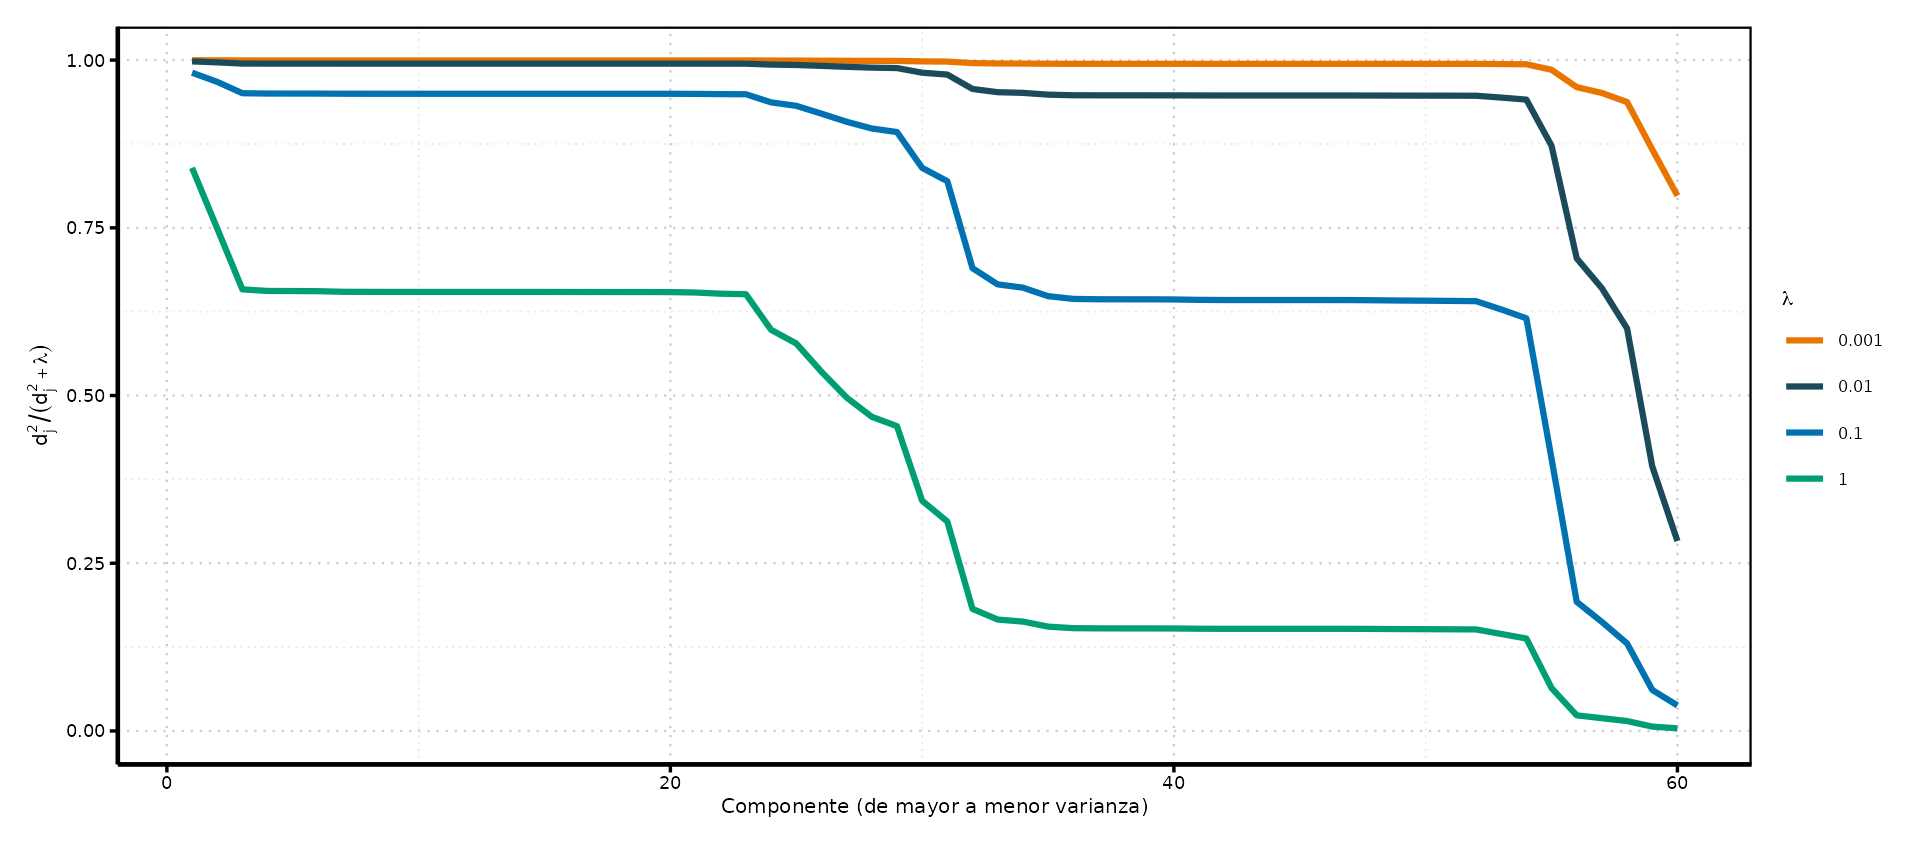
- Factor de contracción d_j^{2}/(d_j^{2}+\lambda)\in(0,1).
- Direcciones de poca varianza (colineales, d_j pequeño) se contraen más — son justo las que producen coeficientes inestables.
![]()
Las direcciones de menor varianza —donde viven combinaciones como temp\approxatemp— son las más contraídas. Ridge no las elimina; les quita influencia.
Por qué estandarizar antes de penalizar
La penalización opera sobre el tamaño numérico de cada coeficiente. Si temp variara entre 0 y 1 y otra variable entre 0 y 1.000, una misma magnitud de coeficiente no sería comparable — la penalización castigaría por unidades, no por importancia real.
z_{ij}=\frac{x_{ij}-\bar{x}_{j,\text{train}}}{s_{j,\text{train}}}.
glmnet estandariza los predictores por defecto, usando solo estadísticas del conjunto de entrenamiento (nunca de validación o test).
Ridge: ejemplo empírico
![]()
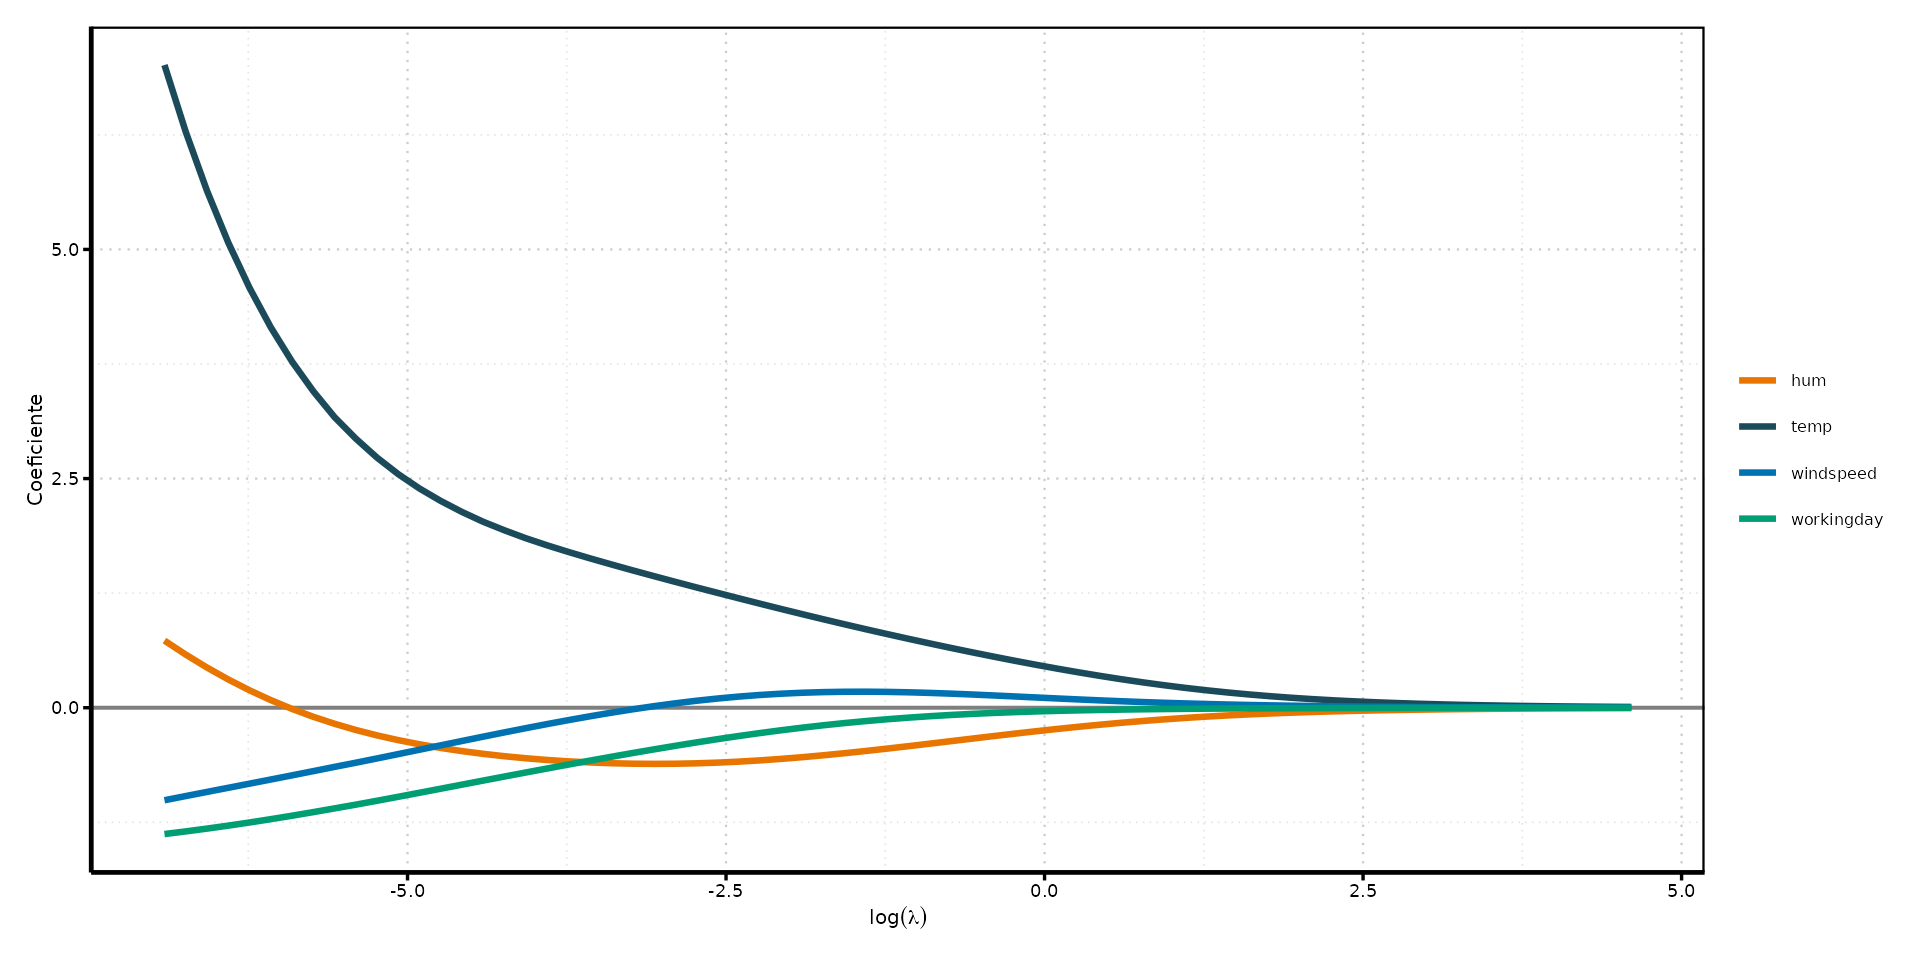
Interpretación: leer la trayectoria
- Hacia la derecha aumenta \lambda; todos los coeficientes se contraen suavemente, sin saltos.
- Ninguna variable desaparece de forma abrupta — consistente con lo que la SVD predijo.
- El signo y el tamaño de cada coeficiente deben interpretarse condicionalmente al resto del modelo, igual que en cualquier GLM.
- Esta trayectoria muestra cómo cambia el modelo con \lambda; todavía no nos dice cuál \lambda predice mejor — eso lo resolveremos con validación, más adelante en la clase.
Motivación: Ridge nunca elige
Ridge resuelve la inestabilidad, pero deja un problema abierto: nunca elimina un predictor. Con muchas variables (interacciones, indicadores de calendario), sería útil que el propio ajuste nos dijera cuáles sobran — no solo que las encoja un poco.
LASSO cambia la forma de la penalización para lograr justamente eso: contracción y selección de variables, en el mismo procedimiento.
Descomposición matemática: soft-thresholding
Con predictores ortonormales, la solución LASSO es explícita — y deja ver el mecanismo exacto de la selección:
\widehat\beta_j^{\text{lasso}}
=\operatorname{sign}\!\big(\widehat\beta_j^{\text{OLS}}\big)\,
\big(|\widehat\beta_j^{\text{OLS}}|-\lambda\big)_+ .
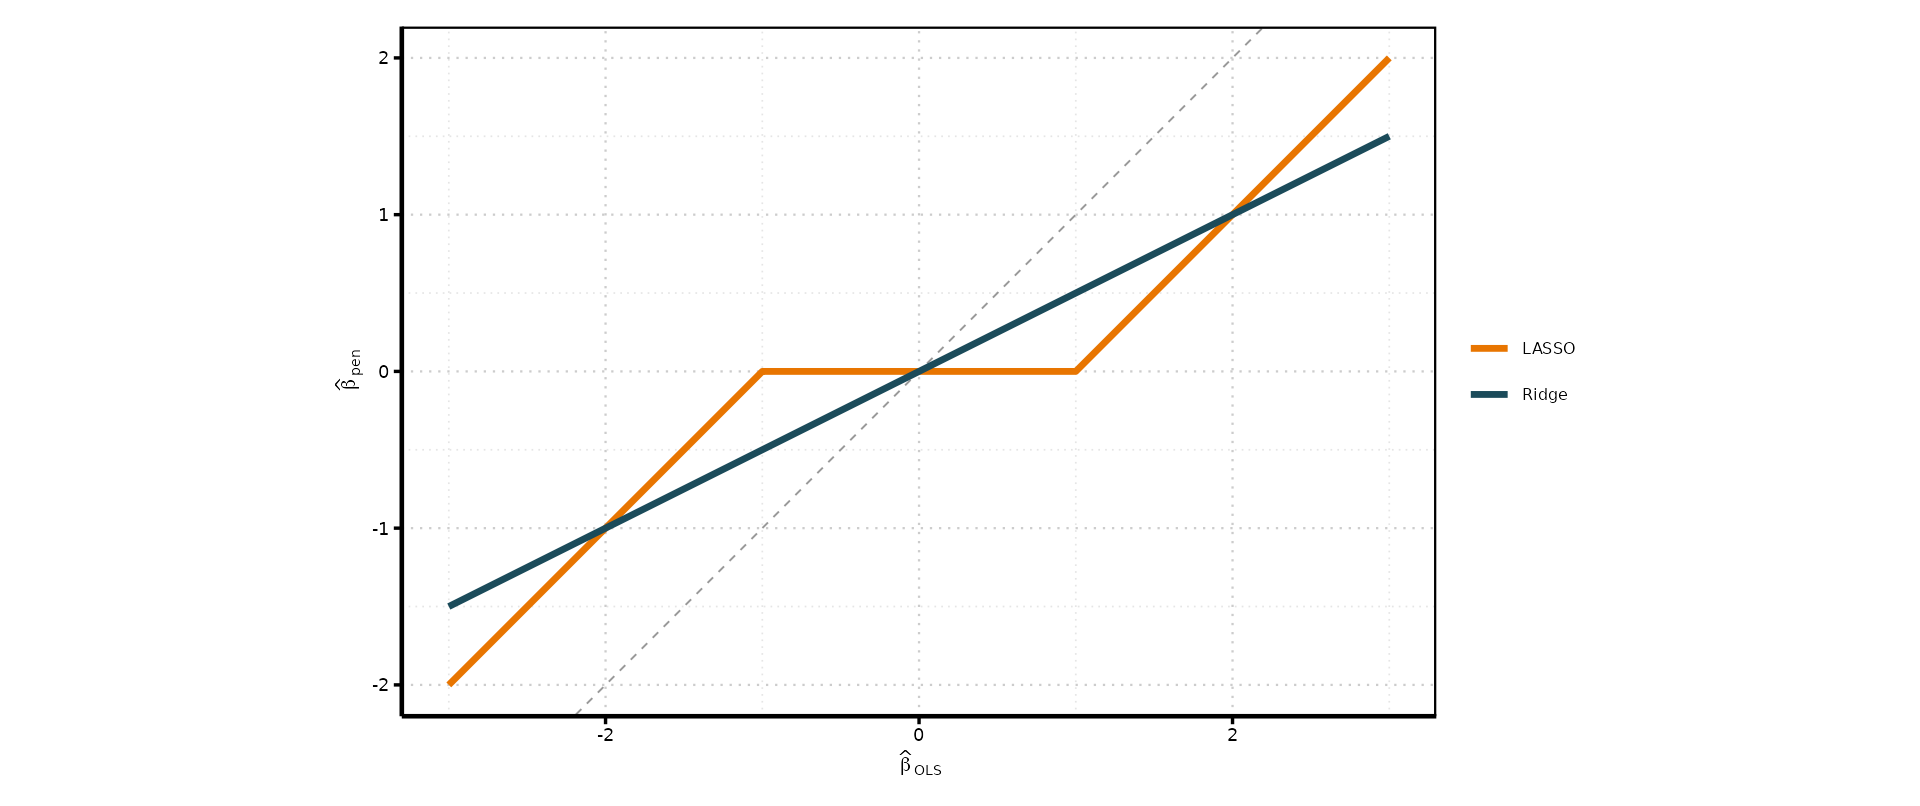
- (\cdot)_+ = parte positiva: si |\widehat\beta_j^{\text{OLS}}|<\lambda, el coeficiente se vuelve exactamente 0.
- Ridge, en cambio, escala todos por igual: \widehat\beta_j^{\text{ridge}}=\widehat\beta_j^{\text{OLS}}/(1+\lambda) — nunca llega a 0 exacto.
![]()
Cómo se optimiza en la práctica
glmnet usa descenso por coordenadas: fija todos los coeficientes menos uno y lo actualiza con la fórmula de soft-thresholding sobre los residuos parciales, ciclando hasta converger. En logística se combina con IRLS (mínimos cuadrados ponderados iterados, la misma idea que vimos en la clase de MLE).
- Existe un \lambda_{\max}=\max_j |x_j^\top(y-\bar y)|/n donde todos los coeficientes son 0; por eso la trayectoria empieza vacía.
- La ruta se calcula desde \lambda_{\max} hacia abajo con warm starts: cada solución inicializa la siguiente.
- Alternativa clásica con el mismo resultado: LARS (Least Angle Regression), un algoritmo distinto que también traza la ruta completa de LASSO.
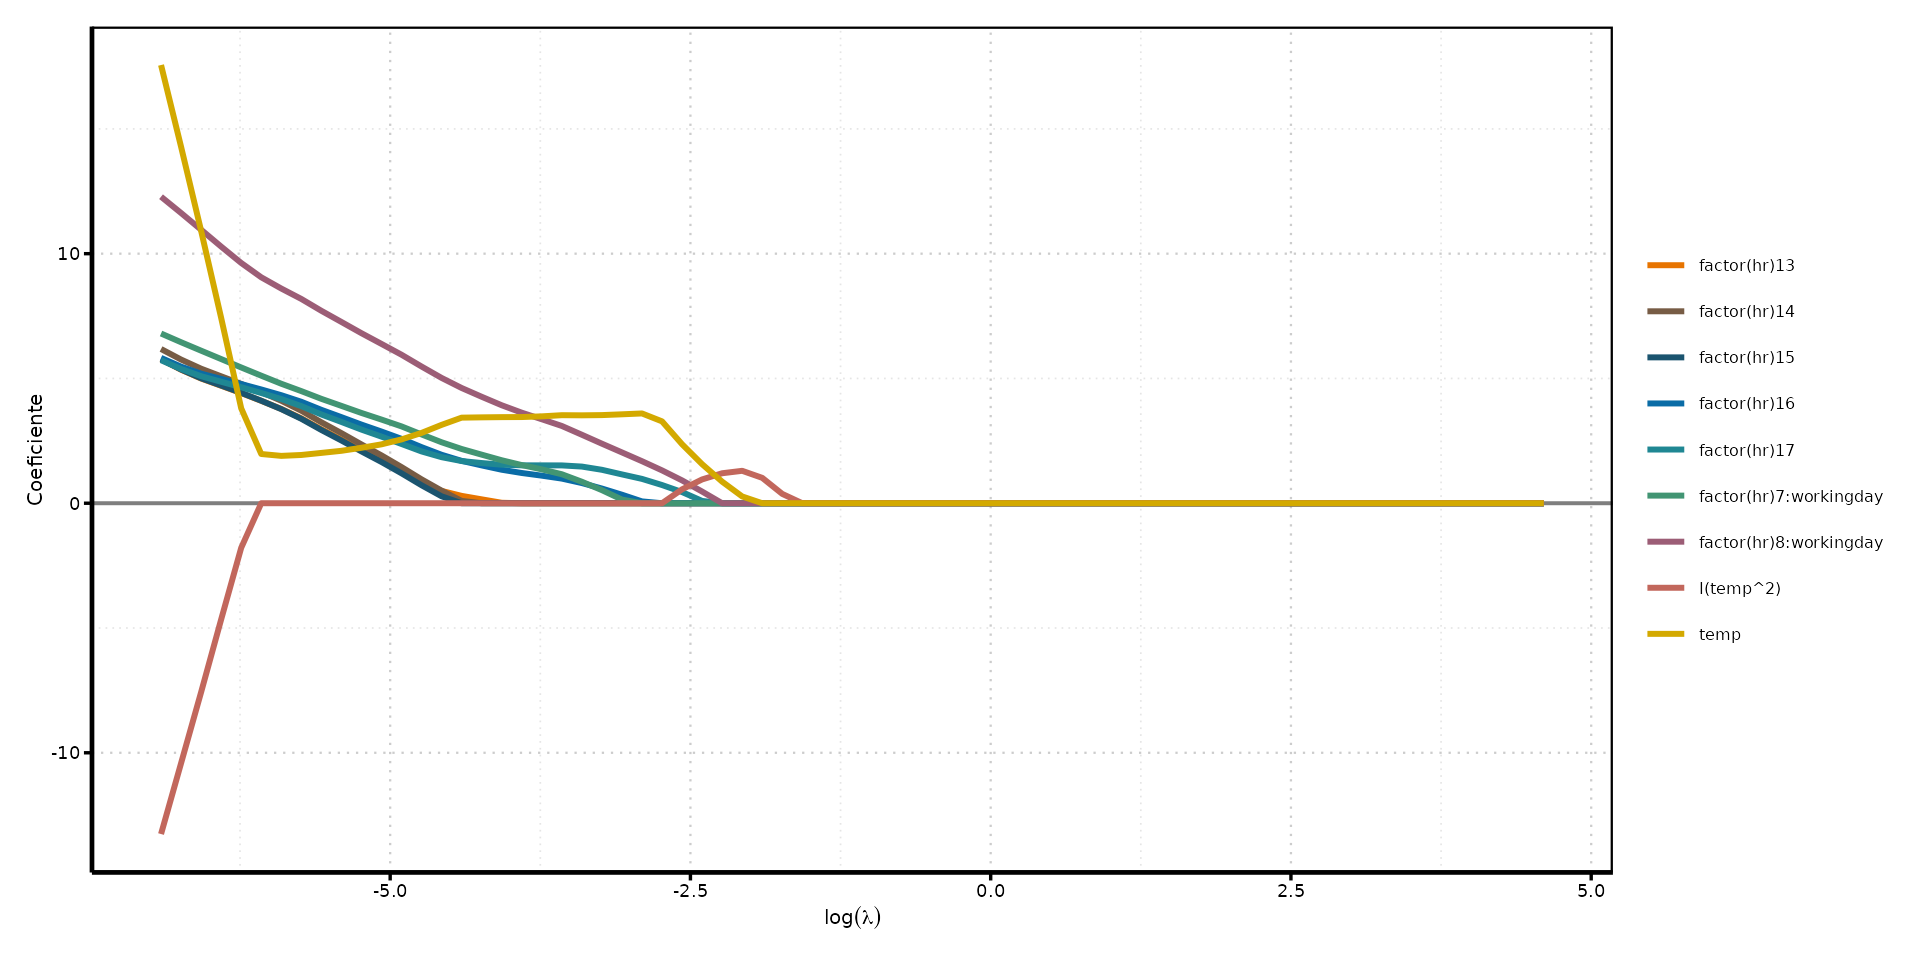
LASSO: ejemplo empírico
![]()
Interpretación: a diferencia de Ridge
Compare esta trayectoria con la de Ridge: aquí las variables entran y salen del modelo en puntos concretos de \lambda, no se contraen todas parejo. Cada vez que una línea toca el cero y se queda ahí, esa variable fue excluida para ese nivel de penalización.
Motivación: cuando además hay bloques correlacionados
LASSO selecciona, pero con predictores muy correlacionados (temp, atemp, mes, estacionalidad) tiende a elegir uno arbitrariamente y descartar el resto — muestras parecidas pueden terminar con variables distintas seleccionadas.
Elastic Net combina ambas penalizaciones para resolver esto:
P_{\alpha}(\boldsymbol\beta)=
(1-\alpha)\frac{1}{2}\sum_j\beta_j^2+
\alpha\sum_j|\beta_j|.
| 0 |
Ridge |
conserva todos los predictores |
| 1 |
LASSO |
produce soluciones dispersas |
| entre 0 y 1 |
Elastic Net |
combina estabilidad y selección |
El término L_2 reparte el peso entre variables correlacionadas (efecto de agrupamiento); el término L_1 conserva la capacidad de anular bloques irrelevantes.
Otros casos de uso
La misma familia de penalizaciones (L_1, L_2, combinadas) aparece, con el mismo objetivo — controlar complejidad cuando hay muchos predictores o predictores correlacionados —, en dominios muy distintos:
| Genómica |
LASSO para seleccionar genes relevantes entre miles, con pocos pacientes |
| Finanzas |
Ridge para estabilizar modelos de riesgo con indicadores macroeconómicos correlacionados |
| Texto / NLP |
LASSO sobre miles de frecuencias de palabras, para quedarse con las predictivas |
| Marketing |
Elastic Net en modelos de churn con decenas de variables de comportamiento correlacionadas |
| Neuroimagen |
Elastic Net para seleccionar vóxeles relevantes entre decenas de miles |
En todos los casos, el problema de fondo es el mismo que vimos hoy: muchos predictores, posible colinealidad, y la necesidad de controlar complejidad sin decidir a mano qué variable entra.
Comparación sistemática
| Penalización |
L_2 |
L_1 |
L_1+L_2 |
| Coeficientes |
todos se achican, ninguno en 0 |
algunos exactamente 0 |
algunos en 0, resto achicado |
| Supuesto implícito |
todos los predictores aportan algo |
pocos predictores realmente importan |
hay bloques correlacionados |
| Hiperparámetros |
\lambda |
\lambda |
\lambda y \alpha (2 dimensiones) |
| Costo computacional |
bajo (ruta cerrada por dirección) |
bajo (coordenadas) |
bajo, pero grilla 2D más cara |
| Interpretabilidad |
media (todos los coeficientes activos) |
alta (modelo disperso) |
media-alta |
| Debilidad típica |
no simplifica el modelo |
descarta arbitrariamente entre correlacionados |
más costoso de tunear |
La decisión final es empírica: se compara desempeño de validación, no una preferencia a priori — lo hacemos a continuación.
Extensiones
- Adaptive LASSO: pondera la penalización de cada coeficiente según una estimación previa, reduciendo el sesgo de selección de LASSO estándar.
- Group LASSO: en vez de anular coeficientes individuales, anula grupos completos — por ejemplo, todos los indicadores de una variable categórica (como
factor(hr)) entran o salen juntos.
- SCAD / MCP: penalizaciones no convexas que corrigen el sesgo hacia cero que Ridge y LASSO imponen a coeficientes grandes.
Todas resuelven variantes del mismo problema — controlar complejidad automáticamente — con ajustes a cómo se reparte la penalización.
Por qué la validación no es un anexo
Elegimos \alpha y \lambda; ninguno de los dos se estima maximizando la verosimilitud del modelo. Si los eligiéramos mirando qué tan bien ajustan el conjunto de entrenamiento, siempre ganaría \lambda=0 — el problema con el que empezamos la clase. Por eso la validación no es un paso posterior: es la forma concreta de resolver el compromiso sesgo-varianza sin hacer trampa.
Protocolo de tuning
- Definir una grilla de \alpha.
- Ajustar una trayectoria de \lambda en entrenamiento.
- Predecir validación para cada combinación.
- Elegir la menor pérdida de validación.
- Reajustar con entrenamiento + validación.
- Evaluar una vez en test.
Validación simple vs. validación cruzada
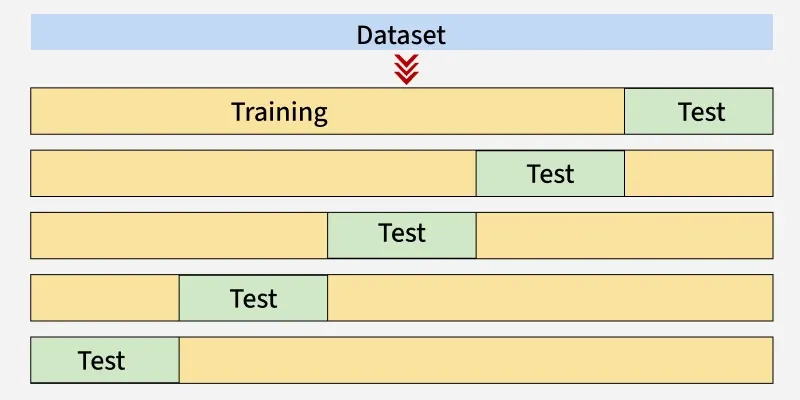
La idea de fondo de cualquier validación: en vez de “memorizar una única prueba”, evaluar el modelo como si rindiera varios exámenes distintos y ver si el desempeño es consistente.
\text{CV}(\lambda)=\frac{1}{k}\sum_{f=1}^{k}\text{pérdida}_f(\lambda).
![]()
k-fold cross-validation: los datos se dividen en k bloques; en cada ronda uno actúa como validación y el resto como entrenamiento.
Con dependencia temporal como la nuestra, la CV aleatoria de la figura es optimista: horas vecinas se filtran entre pliegues. Por eso usamos un conjunto de validación fijo, cronológico.
Validación cronológica (“rolling-origin”)
El análogo correcto de k-fold cuando los datos son series de tiempo se llama validación cruzada de series de tiempo (rolling-origin / walk-forward): cada “pliegue” entrena solo con el pasado y valida con un bloque futuro, avanzando el origen de entrenamiento en cada ronda. Es la generalización, a k rondas, de la partición cronológica única que usamos hoy.
Otras alternativas para elegir \lambda sin re-ajustar muchas veces: validación cruzada generalizada (GCV), y criterios de información como AIC/BIC.
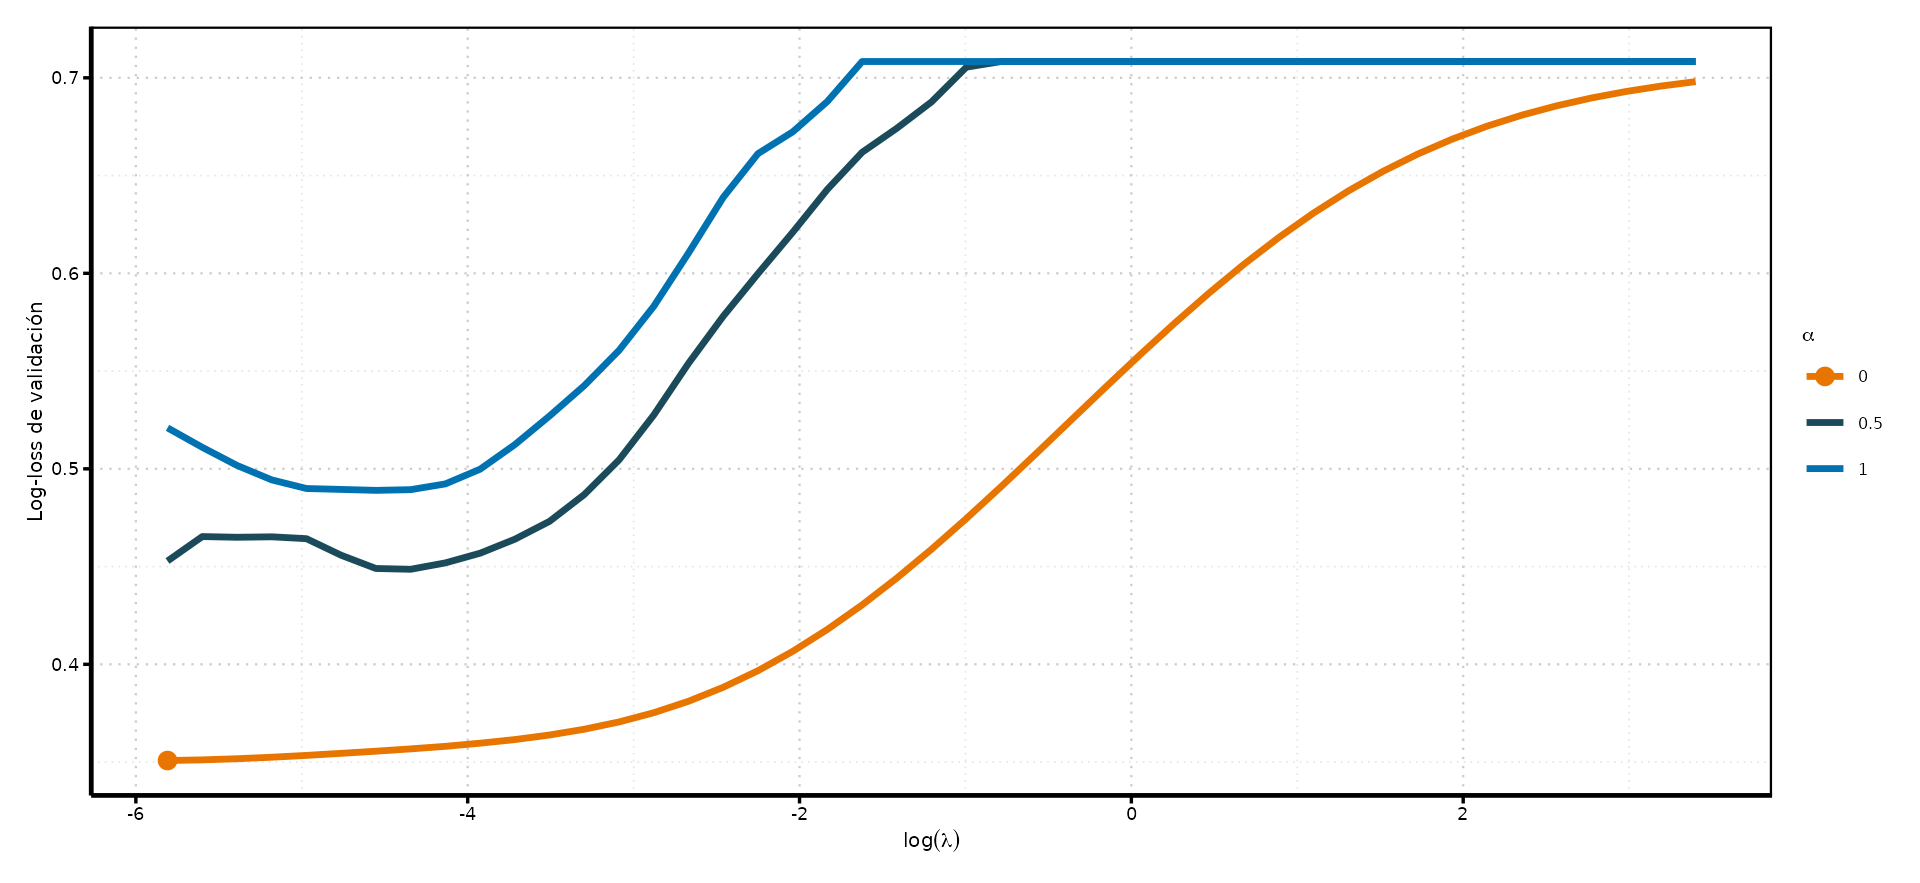
Validación de α y λ: ejemplo empírico
# A tibble: 5 × 3
  alpha  lambda  loss
  <dbl>   <dbl> <dbl>
1     0 0.003   0.351
2     0 0.004 0.351
3     0 0.005 0.352
4     0 0.006 0.352
5     0 0.007 0.353
![]()
Reajuste final y test: ejemplo empírico
# A tibble: 1 × 3
  alpha lambda validation_log_loss
  <dbl>  <dbl>               <dbl>
1     0  0.003               0.351
El umbral se elige en validación minimizando el mismo costo de la clase 15: un falso negativo cuesta tres veces un falso positivo. El test no participó en ninguna de estas decisiones.
Interpretación: ¿la penalización aporta?
# A tibble: 2 × 7
  modelo              log_loss accuracy sensitivity specificity precision cost_per_100
  <chr>                  <dbl>    <dbl>       <dbl>       <dbl>     <dbl>        <dbl>
1 Logit sin penalizar    0.323    0.822       0.937       0.781     0.605         21.100
2 Ridge                  0.306    0.747       0.991       0.659     0.510         25.800
La penalización se juzga contra el logit sin penalizar bajo el mismo protocolo. Puede mejorar log-loss o estabilidad sin reducir el costo operacional; en ese caso, la solicitud predictiva —no la novedad del método— decide cuál preferir.
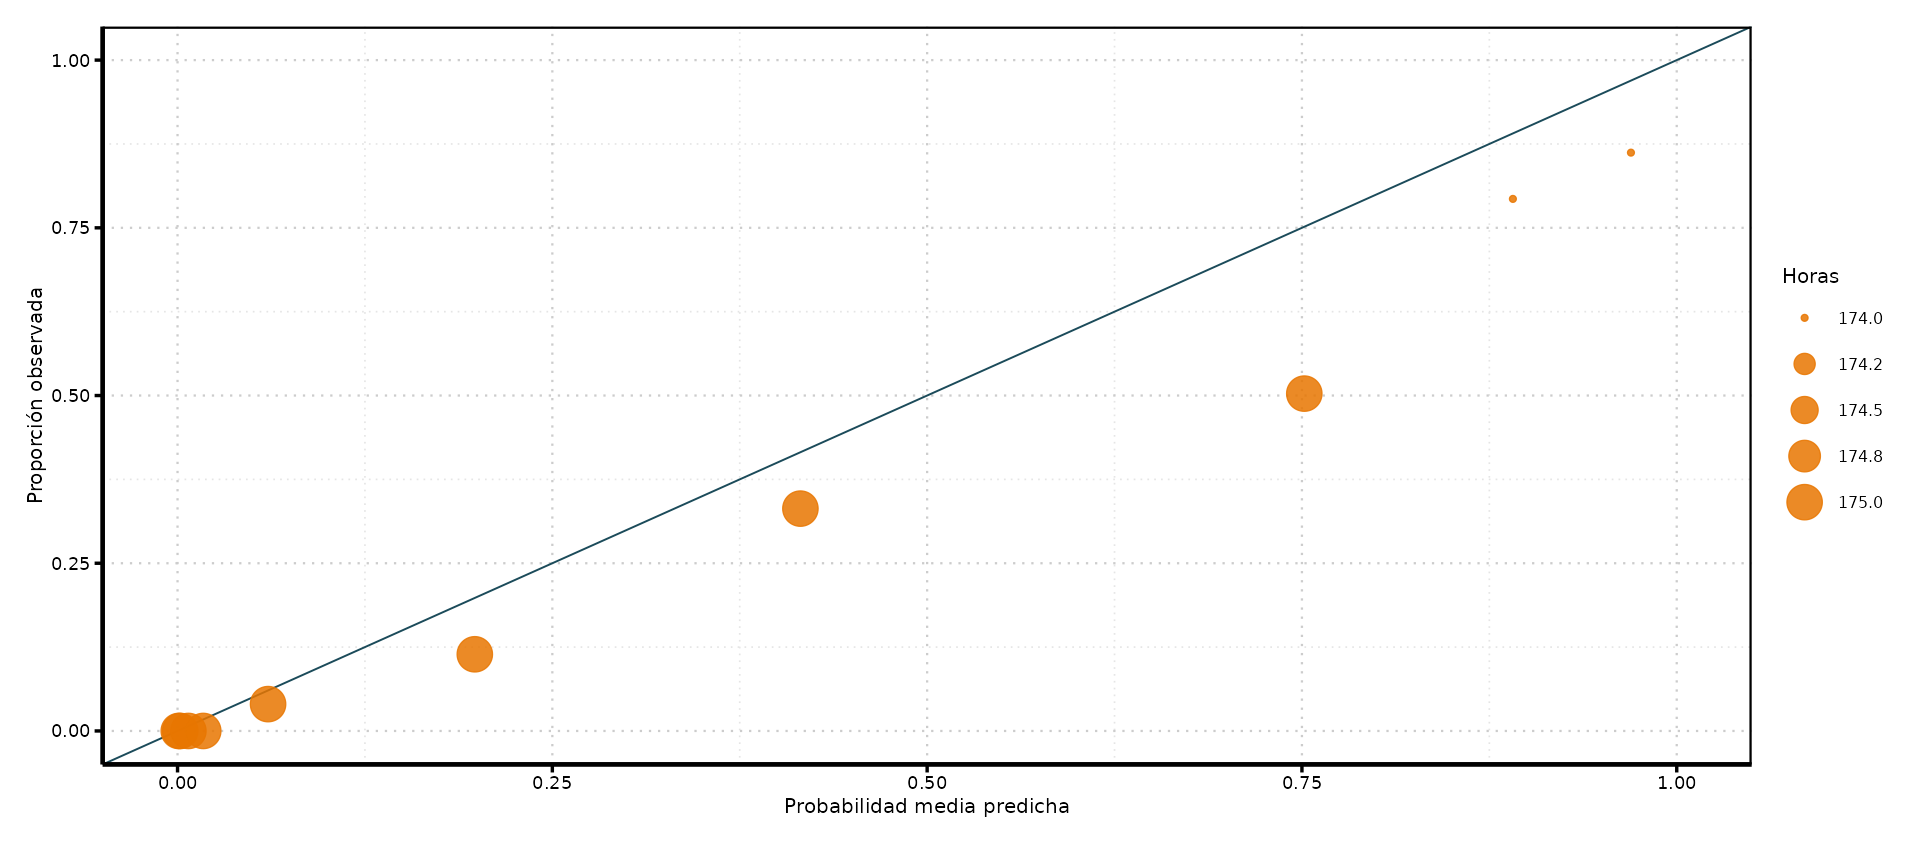
Interpretación: clasificación y calibración
         predicho
observado baja alta
     baja  848  439
     alta    4  457
![]()
Los falsos negativos son horas de demanda alta que el sistema no anticipó. Discriminación (matriz de confusión) y calibración (¿las probabilidades predichas se cumplen en la frecuencia correcta?) son propiedades distintas — un modelo puede discriminar bien y calibrar mal, o viceversa.
Una predicción regularizada, de punta a punta
# A tibble: 1 × 10
    día  hora temperatura alpha lambda probabilidad umbral acción    demanda_observada clase_observada
  <dbl> <int>       <dbl> <dbl>  <dbl>        <dbl>  <dbl> <chr>                 <dbl> <chr>
1   354     8        0.420     0  0.003        0.997    0.100 priorizar               432 alta
La regularización modifica cómo se estiman los coeficientes; la interfaz operacional sigue siendo la misma: fila futura → probabilidad → umbral → acción.
Interpretación: ¿qué variables quedan?
# A tibble: 10 × 3
   variable                coefficient selected
   <chr>                         <dbl> <lgl>
 1 factor(hr)8:workingday         8.590 TRUE
 2 factor(hr)7:workingday         5.650 TRUE
 3 factor(hr)10:workingday       -4.550 TRUE
 4 factor(hr)16                   4.120 TRUE
 5 factor(hr)14                   4.090 TRUE
 6 atemp                          4.010 TRUE
 7 factor(hr)17                   3.990 TRUE
 8 factor(hr)11:workingday       -3.860 TRUE
 9 factor(hr)13                   3.760 TRUE
10 factor(hr)12                   3.730 TRUE
Un coeficiente igual a cero no demuestra irrelevancia sustantiva: solo dice que, bajo esta penalización y esta muestra, esa variable no ayudó a predecir. La selección puede cambiar entre muestras parecidas — no es una prueba de hipótesis.
Comparación con selección clásica
| Mejor subconjunto |
prueba todas las combinaciones |
dura (0/1) |
inviable con p grande |
| Paso a paso (stepwise) |
agrega/quita una variable a la vez |
dura |
greedy, inestable |
| Ridge / LASSO / Elastic Net |
penalización continua |
según método |
convexo, reproducible |
La regularización reemplaza la selección discreta (combinatoria, inestable, la que un GLM clásico haría “a mano” comparando AIC entre modelos) por una continua — el mismo objetivo del stepwise selection de la clase 15, resuelto de forma más estable.
Cuándo puede engañar
- Correlación fuerte: LASSO elige arbitrariamente entre predictores casi equivalentes.
- Inferencia post-selección: los p-valores clásicos no son válidos tras seleccionar con los mismos datos que se usan para inferencia.
- p\gg n: LASSO selecciona a lo sumo n variables, aunque más sean relevantes.
- Escalas ignoradas: sin estandarizar, la penalización castiga por unidades, no por importancia.
- Fuga de información: estandarizar o elegir \lambda mirando el test infla el desempeño reportado.
Síntesis conceptual
La regularización es una respuesta directa al compromiso sesgo–varianza con el que abrimos la clase: introducimos un sesgo controlado (\lambda P_\alpha) a cambio de mucha menos varianza y un ajuste reproducible.
- Ridge (L_2): estabiliza, no selecciona; resuelve la colinealidad.
- LASSO (L_1): contrae y selecciona vía soft-thresholding.
- Elastic Net: combina ambos cuando hay bloques correlacionados.
Todo el resto del flujo —partición, estandarización, test intacto, calibración— existe para que ese compromiso se resuelva honestamente, sin volver a caer en la curva de sobreajuste del comienzo.
Ejercicio
- Agregue una interacción entre
workingday y factor(hr).
- Repita el tuning sin observar el test.
- Compare log-loss, costo y calibración contra el modelo de esta clase.
- Examine qué coeficientes sobreviven con LASSO.
- Cambie el costo falso negativo:falso positivo de 3:1 a 5:1.
- Explique por qué una mejora predictiva no basta para hablar de causalidad.
La pregunta que queda abierta
Regularización controla la complejidad de un modelo cuya forma seguimos eligiendo nosotros: seguimos escribiendo a mano I(temp^2), factor(hr) * workingday, y esperando haber adivinado las interacciones correctas.
¿Qué pasa si no sabemos qué interacciones importan? ¿Puede el algoritmo, además de controlar cuánta complejidad usar, descubrir por sí solo qué variables interactúan y cómo? Esa es exactamente la pregunta que abre la próxima clase.
Seguimos usando bicicletas como único caso — pero el mismo procedimiento (penalizar, validar sin mirar el test, elegir hiperparámetros honestamente) es exactamente el que corre detrás de un puntaje de crédito o un score de riesgo: la disciplina que practicamos aquí es la misma que se exige cuando el error afecta a una persona, no a una bicicleta.
En resumen
- Un modelo demasiado flexible ajusta mejor el entrenamiento pero predice peor datos nuevos: sesgo-varianza.
- Ridge estabiliza modelos con predictores correlacionados, sin seleccionar.
- LASSO favorece parsimonia y selección vía soft-thresholding.
- Elastic Net ofrece un continuo entre ambos cuando hay bloques correlacionados.
- \alpha y \lambda se eligen con validación, nunca maximizando el ajuste en entrenamiento.
- La forma funcional del modelo, sin embargo, la seguimos eligiendo nosotros — eso cambia en la próxima clase.
Gracias
Hasta la próxima clase
Mauricio Bucca